

飞书原文 · 源修订 20
💡
机制课: 本课研究世界模型不只用于规划时,还可以在模型内部生成想象轨迹,用这些轨迹训练 Actor、Critic 或技能策略。重点是 imagined rollout 的梯度路径、模型偏差、短滚动与长滚动的权衡。
学习目标
完成本课后,应能区分真实 rollout 和 imagined rollout;写出 Dreamer 类方法的表示、动力学、奖励、价值和策略目标;解释梯度是否穿过世界模型;分析模型误差如何污染策略;设计真实数据与想象数据的混合训练实验。
1. 为什么在模型里学习
真实机器人交互昂贵、慢且危险。若世界模型可以预测潜在状态:
读法: 世界模型根据当前潜在状态和动作,为下一潜在状态给出条件分布。
推导: 这是想象环境的状态转移接口。它来自真实轨迹上学习到的潜在动力学,而不是新采集的真实状态。
就可以在模型内部展开:
读法: 在想象 rollout 的第 k 步,模型把自己的当前预测状态和 Actor 动作推进到下一状态。
推导: 确定性情形下反复复合 f_phi 即得到多步轨迹;随机模型则需在每步采样或传播分布,因此误差与不确定性都会沿 rollout 累积。
然后用预测奖励训练策略:
读法: Actor 的 H 步想象目标,是前 H 个预测奖励的折扣和,加上第 H 步潜在状态的终点价值,并对初始状态、策略动作和模型随机性取期望。
推导: 把无限时域回报在 H 处截断,显式使用模型预测前 H 步,再用 Critic 近似余下尾部;求和到 H-1 恰好包含 H 个奖励。
这不是凭空增加数据,而是用模型假设在数据之间插值。模型错误会被想象训练反复放大。
2. 想象 rollout 的组成
| 模块 | 数学对象 | 作用 |
|---|---|---|
| 表示 | 近似后验 q:由观测历史推断潜在状态 | 把观测映射到决策状态 |
| 动力学 | 潜在转移分布 p:预测动作后的状态 | 预测动作后的状态 |
| 奖励 | 奖励预测器:估计当前状态动作的任务反馈 | 预测任务评价 |
| 终止 | 终止预测器:估计轨迹是否继续 | 预测任务是否结束 |
| Actor | Actor 策略:在潜在状态上选择动作 | 在想象中选动作 |
| Critic | Critic 价值函数:估计未来回报 | 估计未来回报 |
3. Critic 在想象轨迹上学习
想象 TD 目标:
读法: 一步价值目标等于预测即时奖励,加上未终止概率、折扣因子与下一状态目标价值的乘积。
推导: 由 Bellman 递推把长期回报拆成当前奖励和下一状态回报;终止概率为一时不再 bootstrap,目标网络参数 bar xi 用于稳定训练。
读法: lambda-return 在一步目标价值和更长的递归回报之间按 lambda 混合,同时用继续概率控制终止后的回报。
推导: 把不同 n-step return 按几何权重加权可以整理成该递归式;lambda 为零退化为一步 TD,接近一时更依赖长想象回报。
Critic 损失:
读法: Critic 最小化自身价值预测与停止梯度后的 lambda-return 目标之间的均方误差。
推导: 把 return 当作回归监督即可得到平方损失;停止梯度算子 sg 防止 Critic 通过修改目标分支而不是价值预测来缩小误差。
如果世界模型在某区域预测错误,Critic 会把模型幻想当成未来真实回报。可以限制想象 horizon、混入真实 next state 或使用 ensemble 不确定性。
4. Actor 的梯度路径
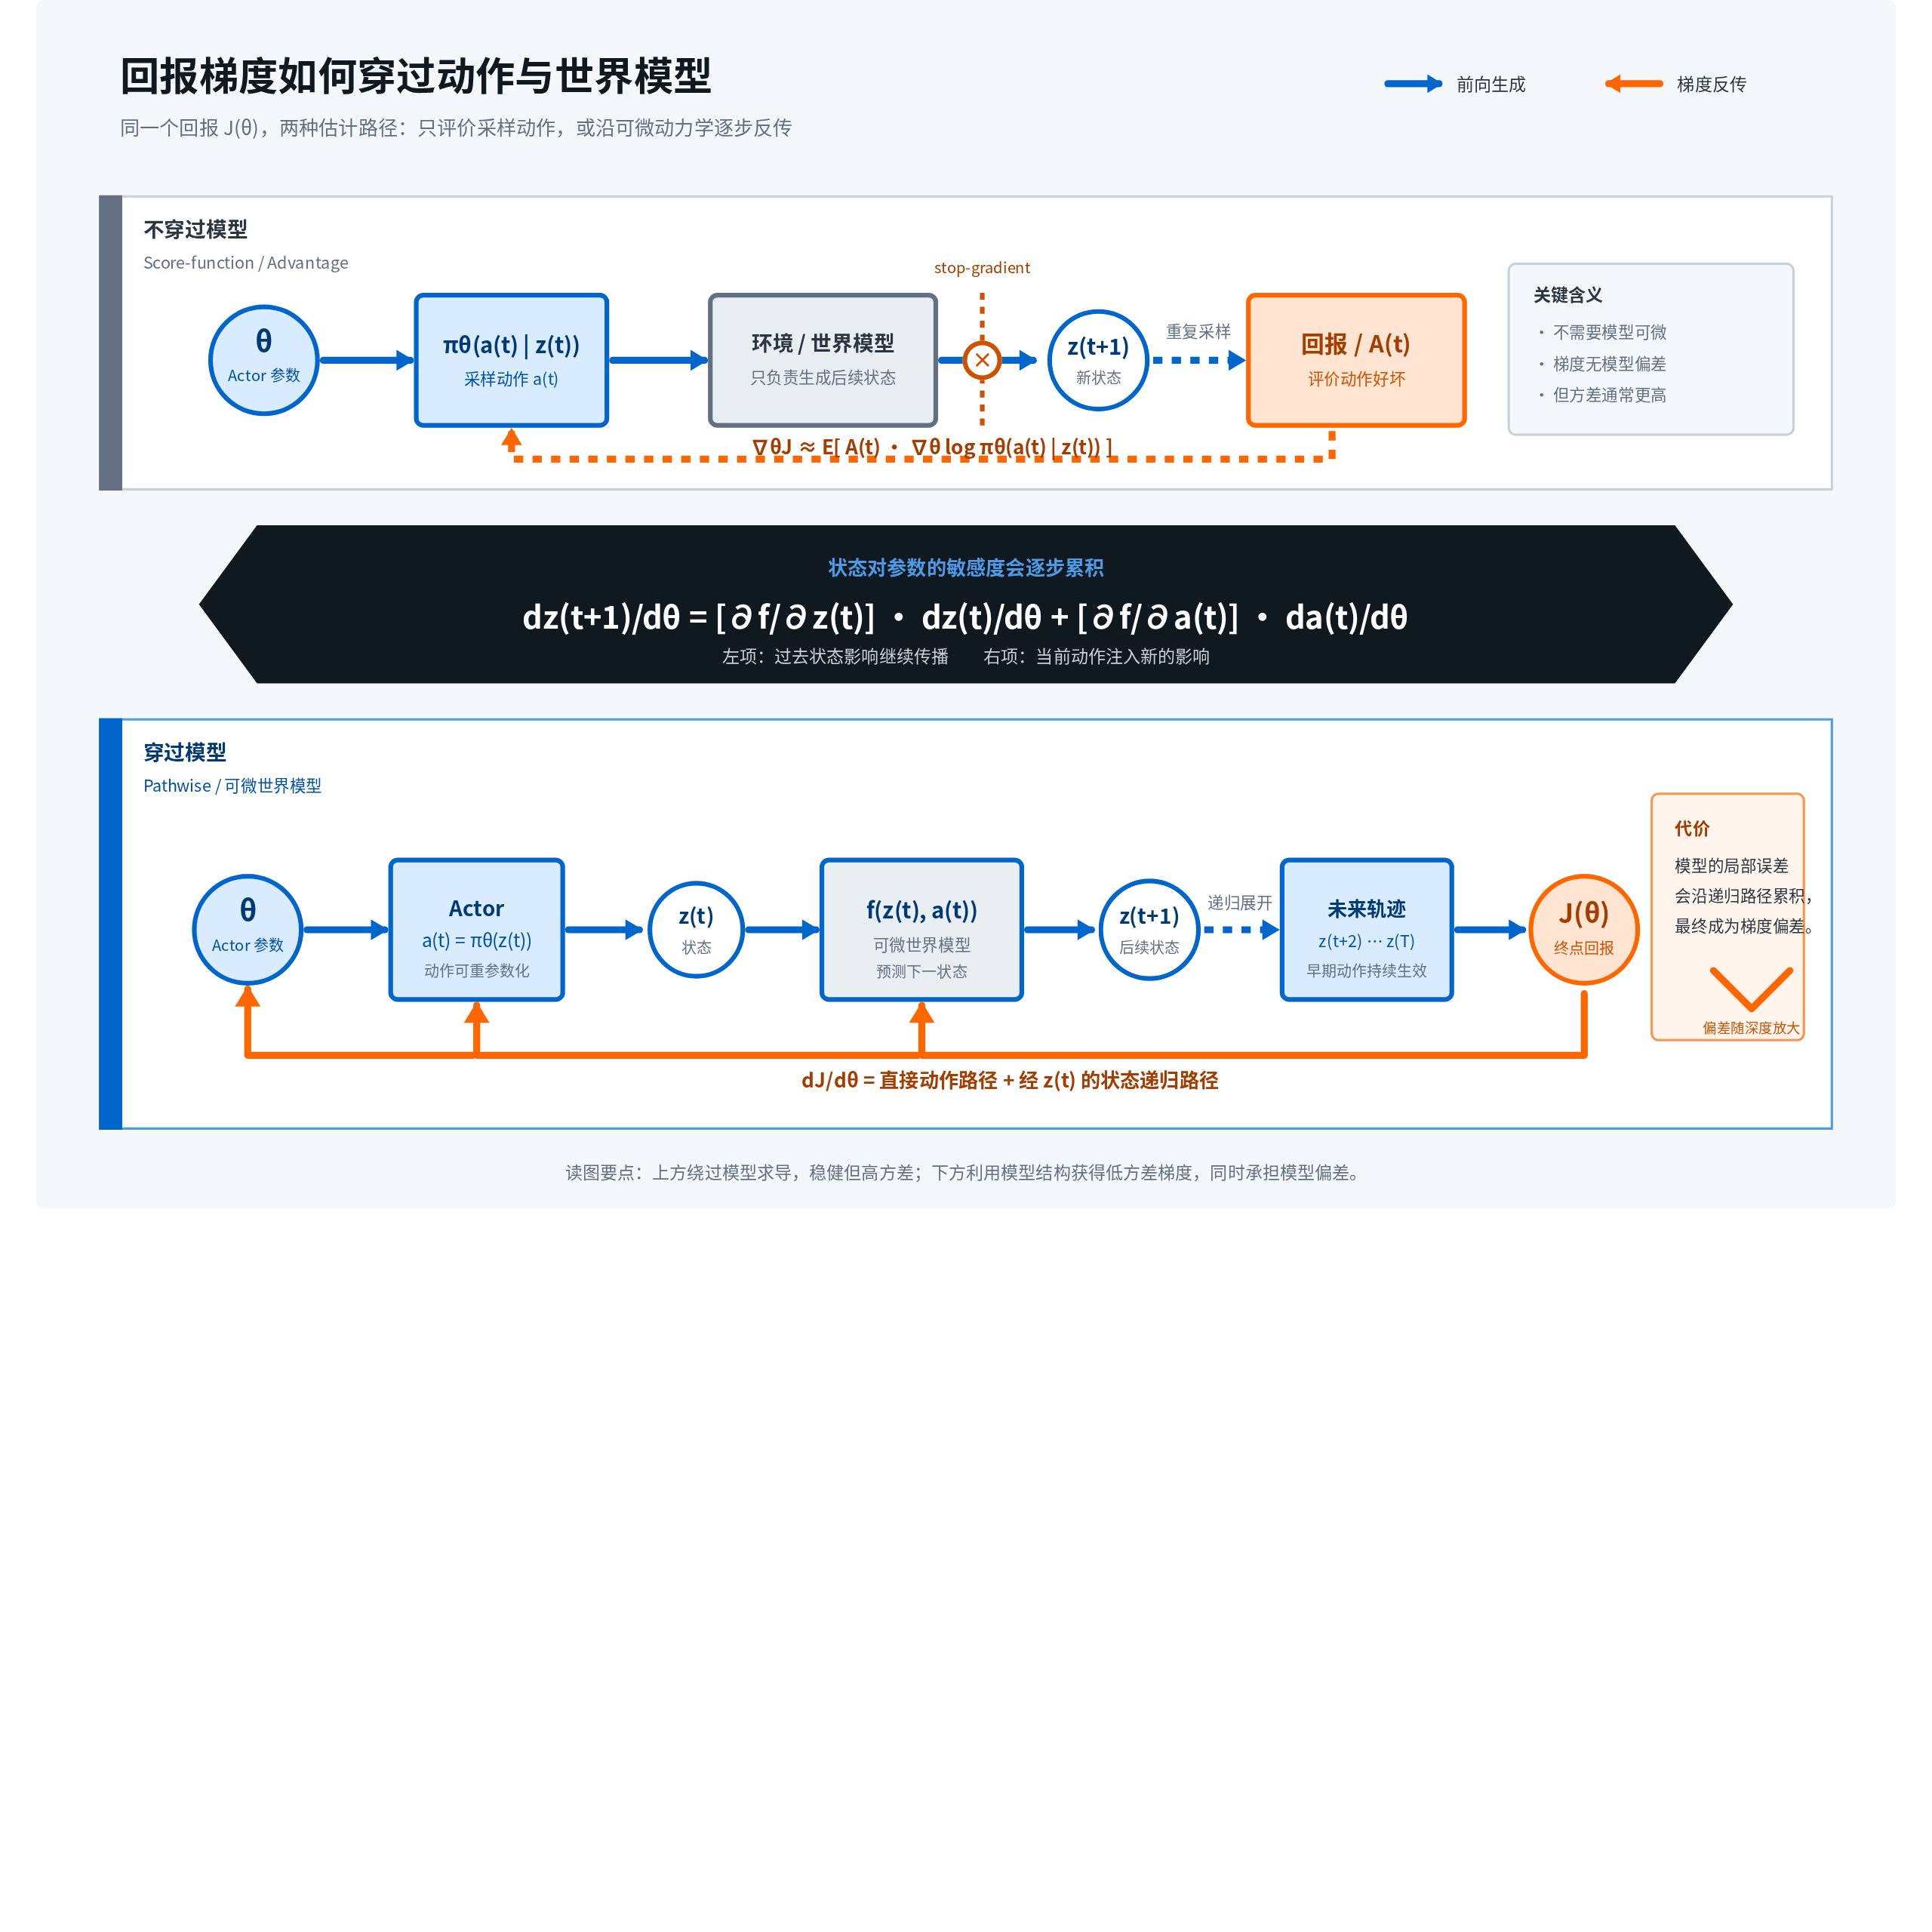
4.1 不穿过模型的策略梯度
把世界模型当作环境,使用想象状态和 Advantage:
读法: 策略梯度把每一步动作的对数概率梯度,乘以该动作相对平均水平的优势,再沿想象时域求和并取期望。
推导: 对轨迹概率使用 log-derivative trick;不对世界模型求导时,模型只负责产生采样状态,Advantage 用作降低方差的回报权重。
优点是简单;缺点是模型错误只通过数据分布间接影响。
4.2 穿过模型的路径优化
若动力学可导,可以让回报梯度穿过模型:
读法: Actor 参数既通过当前动作直接影响回报,也通过动作改变下一状态、再递归影响以后所有回报。
推导: 对可重参数化的策略和可导动力学使用全导数与链式法则;第二行显式保留状态递归,因此不会遗漏早期动作对后续状态的间接影响。
样本效率高,但模型的微小系统性错误可能直接变成策略的错误梯度。
公式可视化|回报梯度如何穿过动作与世界模型
5. 真实数据与想象数据的混合
| 训练方式 | 真实数据比例 | 优势 | 风险 |
|---|---|---|---|
| 纯真实 | 100% | 不受模型幻想污染 | 交互成本高 |
| 短想象 | 真实初始化,短 rollout | 偏差较小、扩展有效 | 长期价值有限 |
| 长想象 | 少量真实初始化 | 覆盖长时决策 | 模型误差累积 |
| 不确定性门控 | 按模型置信度选择 | 在可信区域扩展数据 | 置信度校准困难 |
6. Dreamer 类方法的抽象流程
- 用真实轨迹训练表示、动力学、奖励和终止模型。
- 从真实观测编码潜在状态。
- 在潜在空间中由当前 Actor 展开想象轨迹。
- 用想象奖励训练 Critic。
- 让 Actor 选择能提高想象回报的动作。
- 在真实环境执行新策略,收集数据修正世界模型。
Dreamer 的核心不是“生成逼真视频”,而是在足够有用的潜在空间里进行可微或近似可微的决策学习。
7. 模型偏差的三种传播
| 偏差 | 传播方式 | 诊断 |
|---|---|---|
| 状态表示偏差 | Actor 和 Critic 看到了错误状态 | 遮挡、历史长度、表征探针 |
| 动力学偏差 | 每一步预测误差成为下一步输入 | 多步 open-loop 与真实 rollout |
| 奖励偏差 | 策略追求模型定义的伪目标 | 模型内回报与真实成功率相关性 |
8. 想象学习与 VLA 的结合
VLA 可以作为 Actor,世界模型生成潜在未来,Critic 对 Action Chunk 进行评价:
读法: 动作块 A_t 的价值,是世界模型预测的 H 步奖励与终点价值之和的期望;动作块恰好包含从 t 到 t+H-1 的 H 个动作。
推导: 把单步动作价值扩展为固定长度动作块,并对模型生成的未来边缘化;该分数可用于候选 Action Chunk 重排或价值引导。
这可以用于候选动作重排、价值条件化、生成策略的 guidance 或低层技能选择。它不意味着 VLA 自动变成世界模型;必须明确新增了哪一个预测对象和训练信号。
9. 最小实验
- 用真实轨迹拟合一维带摩擦动力学。
- 分别训练纯真实 Actor 和 imagined Actor。
- 扫描 imagination horizon。
- 人为增加动力学偏差,观察策略性能。
- 加入 ensemble 不确定性门控。
- 比较模型内回报、真实回报和 Critic 校准。
10. 论文坐标与证据边界
想象学习的关键不是生成了多少轨迹,而是这些轨迹在哪些状态动作区域可信、Actor 的梯度怎样依赖模型,以及最终是否改善真实闭环。
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| World Models | 先训练视觉潜变量模型与循环动力学,再让控制器在模型中训练 | 压缩后的梦境可支持策略学习 | 建立了清晰范式,但早期视觉游戏结果不能直接证明复杂接触机器人的可用性 |
| MBPO | 从真实状态出发生成短模型 rollout,并与真实数据混合训练策略 | 短 rollout 可平衡模型偏差与样本扩增 | 是检验 imagination horizon 的重要基线;机器人上要进一步处理部分可观测和状态估计误差 |
| Dreamer 系列 | 在 RSSM 的潜在想象轨迹上用 lambda-return 训练价值和 Actor | 可微潜在想象能高效学习长时行为 | 本课的核心路线;应同时报告模型损失、价值校准和真实任务收益,不能只报告最终分数 |
| TD-MPC2 | 结合潜在动力学、价值学习、策略先验与在线短时规划 | 模型学习和局部规划可以共同扩展 | 它不等同于纯 imagined actor,适合作为“想象训练与在线规划混合”的对照路线 |
| RECAP / 机器人经验学习 | 使用真实部署中的成功、失败和纠正继续改进策略 | 真实经验可以弥补离线模仿不足 | 为想象数据提供必要对照:没有真实回流,模型偏差无法被可靠发现和修正 |
11. 本课练习
- 区分 imagined state 和真实观测的统计来源。
- 写出带终止概率的 TD 目标。
- 解释穿过世界模型的梯度为什么可能放大模型错误。
- 设计短想象、长想象和不确定性门控三组对照。
- 说明 VLA、世界模型和 Critic 的联合系统中每个模块学习什么。
- 把 Dreamer 抽象流程映射到一个真实机器人任务。