

飞书原文 · 源修订 15
💡
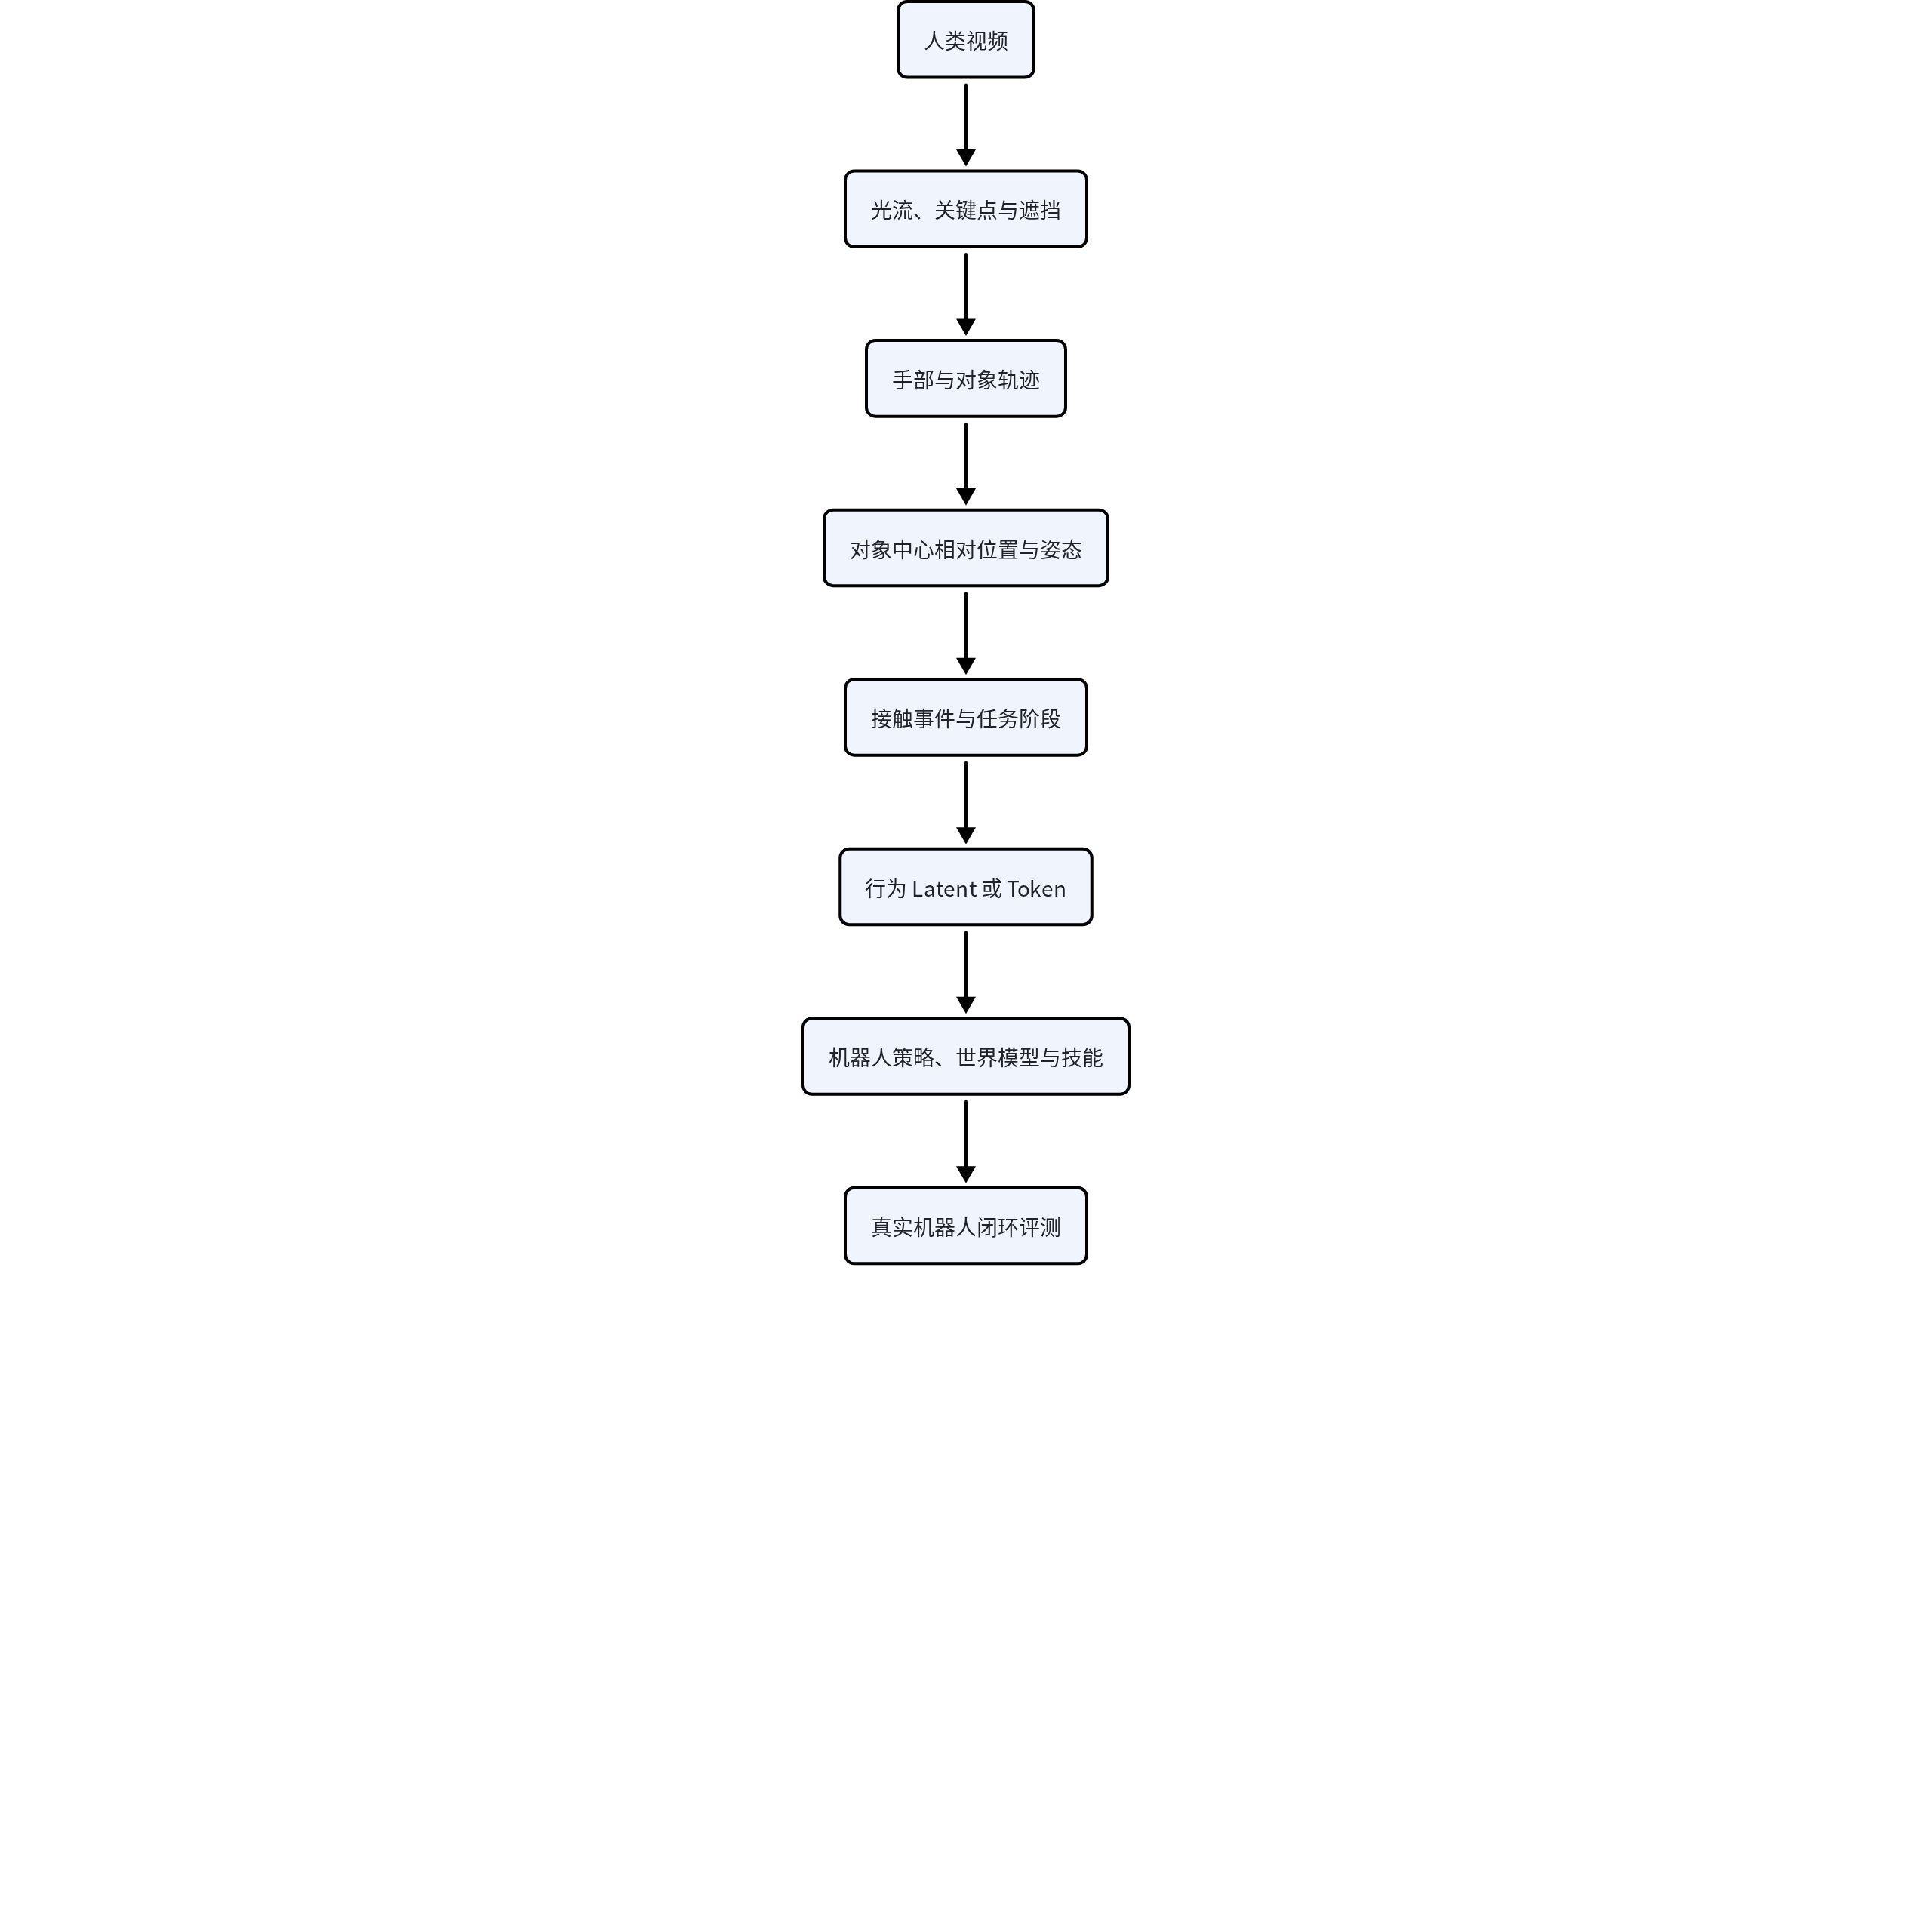
机制课: 本课从视频观测模型出发,解释光流、关键点、3D 运动、对象轨迹和手-物交互图,并说明哪些量可以跨视角和跨本体迁移。
学习目标
完成本课后,应能区分像素运动与物理运动;推导关键点速度和误差传播;构造对象中心与手-物相对表示;理解单目尺度、遮挡和相机运动;设计视频表征对机器人控制收益的验证。
1. 视频观测模型
三维点 经相机投影:
读法: 三维点先经过相机外参和内参变成齐次图像坐标,再经透视除法得到像素坐标。
推导: R_t 和 T_t 把世界点变换到相机坐标,K 把它映射到齐次像素坐标;Pi 再除以深度分量。因为最后一步依赖深度,相同三维位移不会对应固定比例的像素位移。
像素变化同时受物体运动、相机运动、深度和内参影响。因此:
读法: 像素位移不能用一个固定常数 c 乘三维位移来普遍表示。
推导: 透视投影的局部比例随深度、焦距和相机姿态变化;相机自身运动也进入像素差。因此只有在局部深度近似固定且相机已标定、已补偿时,才可能使用局部线性近似。
除非已知相机和深度,否则不能把像素速度直接当物理速度。
2. 光流
亮度恒常假设:
读法: 一个图像点移动 u、v 后,在短时间 Delta t 内亮度近似保持不变。
推导: 若同一表面点在相邻帧中没有显著光照变化,它的新位置应具有相近灰度。反光、阴影、遮挡和接触形变会破坏这个假设,所以光流必须结合鲁棒损失或学习先验。
一阶展开得到光流约束:
读法: 图像在 x、y 和时间方向的亮度梯度,与二维位移 u、v 满足一阶光流约束。
推导: 对亮度恒常式在当前点做一阶 Taylor 展开,减去 I(x,y,t) 后得到 I_xu、I_yv 与 I_t Delta t 的和近似为零。一个方程有两个运动未知量,因此还需要邻域平滑、多个像素或学习模型。
一个方程有两个未知量,需要局部平滑或深度模型。反光、遮挡和接触形变会破坏假设。
3. 关键点与速度
关键点位置估计 ,差分速度:
读法: 关键点速度估计等于相邻两次位置估计之差除以帧间隔。
推导: 这是位置时间导数的前向有限差分。它简单但会把两帧的位置误差同时带入分子,因此帧率提高而定位精度不变时,速度噪声可能反而变大。
若独立位置噪声方差为 :
读法: 若相邻两帧的位置噪声独立且每帧方差为 sigma 平方,差分速度的方差是二倍 sigma 平方除以时间间隔平方。
推导: 速度误差为 epsilon_{t+1} 减 epsilon_t 再除以 Delta t。独立噪声之差的方差等于两者方差之和,因此得到 2 sigma 平方;若噪声有时间相关性,还需加入负二倍协方差项。
帧间隔越小,直接差分越放大噪声,需要平滑、状态空间滤波或轨迹拟合。
4. 手部骨架
手部关键点集合 。可以构造:
- 掌心坐标系。
- 指关节屈曲角。
- 指尖与物体距离。
- 抓型和接触候选。
骨架比像素更结构化,但不包含真实力、皮肤接触面积和物体重量。
5. 对象中心表示
相对位置:
读法: 手相对对象的位置向量等于手的位置减去对象的位置。
推导: 共同的场景平移会在相减时抵消,因此 r_t 更稳定地描述接近、离开和抓取关系。跨视角时还应把该向量表达在对象或相机标定坐标系中。
相对姿态:
读法: 手相对对象的旋转,等于对象旋转的逆乘手旋转。
推导: 旋转矩阵是正交矩阵,所以逆等于转置。先用对象旋转的逆把世界方向变换到对象坐标系,再乘手旋转,就得到手在对象坐标系中的相对姿态。
相对表示比绝对图像坐标更适合跨相机和场景迁移。还可构造手-物交互图,节点表示手部、对象和环境,边表示距离、接触和运动关系。
6. 事件与阶段
| 阶段 | 视觉线索 | 缺失信息 |
|---|---|---|
| 接近 | 距离缩小 | 抓取意图 |
| 接触 | 相对运动突变 | 接触力 |
| 抓稳 | 手物共同运动 | 内部滑动 |
| 运输 | 对象轨迹跟随手 | 负载与阻抗 |
| 释放 | 手物分离 | 对象稳定性 |
事件表示往往比固定时间窗口更适合作为技能和 Tokenizer 边界。
7. 三维恢复
多视角、深度相机、人体模型和对象模型可以减少歧义。单目 3D 仍依赖尺度、先验和相机假设。评测应分别报告 2D、3D 和控制收益,不把重建精度直接等同于机器人可用性。
8. 最小实验
使用同一批具有 RGB、相机位姿、深度或多视角三维真值的视频,只给模型 RGB 输入。比较光流、关键点差分、平滑轨迹、对象中心相对表示和三维恢复,并把各表征接入同一少样本机器人策略。
最低报告项: 光流端点误差、关键点跟踪误差、速度方向与方差校准、相对位姿误差、事件边界 F1、遮挡恢复、新视角与移动相机留出,以及固定机器人演示数量下的闭环成功率。
- 提取手和对象关键点。
- 比较直接差分、平滑和 Kalman 速度。
- 比较绝对坐标和对象相对坐标。
- 训练接触阶段分类器。
- 将表示用于机器人少样本策略。
- 做相机运动、尺度和遮挡留出。
9. 本课练习
- 推导差分速度的噪声方差。
- 解释光流 aperture problem。
- 为抓取构造手-物交互图。
- 设计“共同运动不等于抓稳”的反例。
- 比较 2D、3D 和对象中心表示。
- 说明视频表征如何连接 VLA、世界模型和分层技能。
10. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 亮度恒常失效 | 反光、阴影或快速曝光变化导致错误光流 | 光度增强、鲁棒损失和学习式匹配 |
| Aperture problem | 沿长边只能观测法向运动,切向速度不确定 | 扩大空间上下文、多个角点或全局匹配 |
| 关键点噪声放大 | 位置误差很小但差分速度剧烈抖动 | 报告噪声协方差,使用滤波与轨迹拟合 |
| 身份切换 | 遮挡后跟踪到另一只手或另一个物体 | 长期身份一致性、重识别和分段置信度 |
| 相机运动混入对象运动 | 整个场景产生相似方向光流 | 相机位姿估计、背景点补偿和固定相机对照 |
| 单目尺度漂移 | 三维轨迹形状合理但物理尺度随时间变化 | 已知对象尺度、深度、多视角或尺度不变指标 |
| 对象中心图缺失接触 | 手靠近对象却无法判断是否抓稳或滑动 | 接触事件、力觉、触觉和对象状态变化 |
| 表征指标与控制脱钩 | 2D/3D 误差下降但机器人成功率不变 | 冻结控制器和数据预算,报告下游闭环消融 |
11. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| RAFT | 通过全对相关体和迭代更新估计稠密光流 | 全局匹配与反复细化能提高复杂运动估计 | 高光流精度仍是像素空间证据,不等于恢复三维速度、接触或动作 |
| TAPIR | 对任意查询点进行长时点跟踪,并显式预测遮挡与不确定性 | 点轨迹和可见性适合描述长视频中的对象运动 | 长期身份和遮挡建模对机器人有用,但必须再绑定对象语义、事件和控制 |
| R3M | 从第一视角人类视频预训练表征,并迁移到机器人操作 | 视频交互结构可以形成通用视觉表示 | 需要用固定机器人数据的闭环任务证明收益,而不是只报告表征探针 |
| XSkill | 从人类与机器人视频中学习跨本体技能表示 | 共享的技能空间可以连接不同身体 | embedding 对齐不保证动作可执行,需验证事件边界、对象状态和少样本机器人复用 |