

飞书原文 · 源修订 13
💡
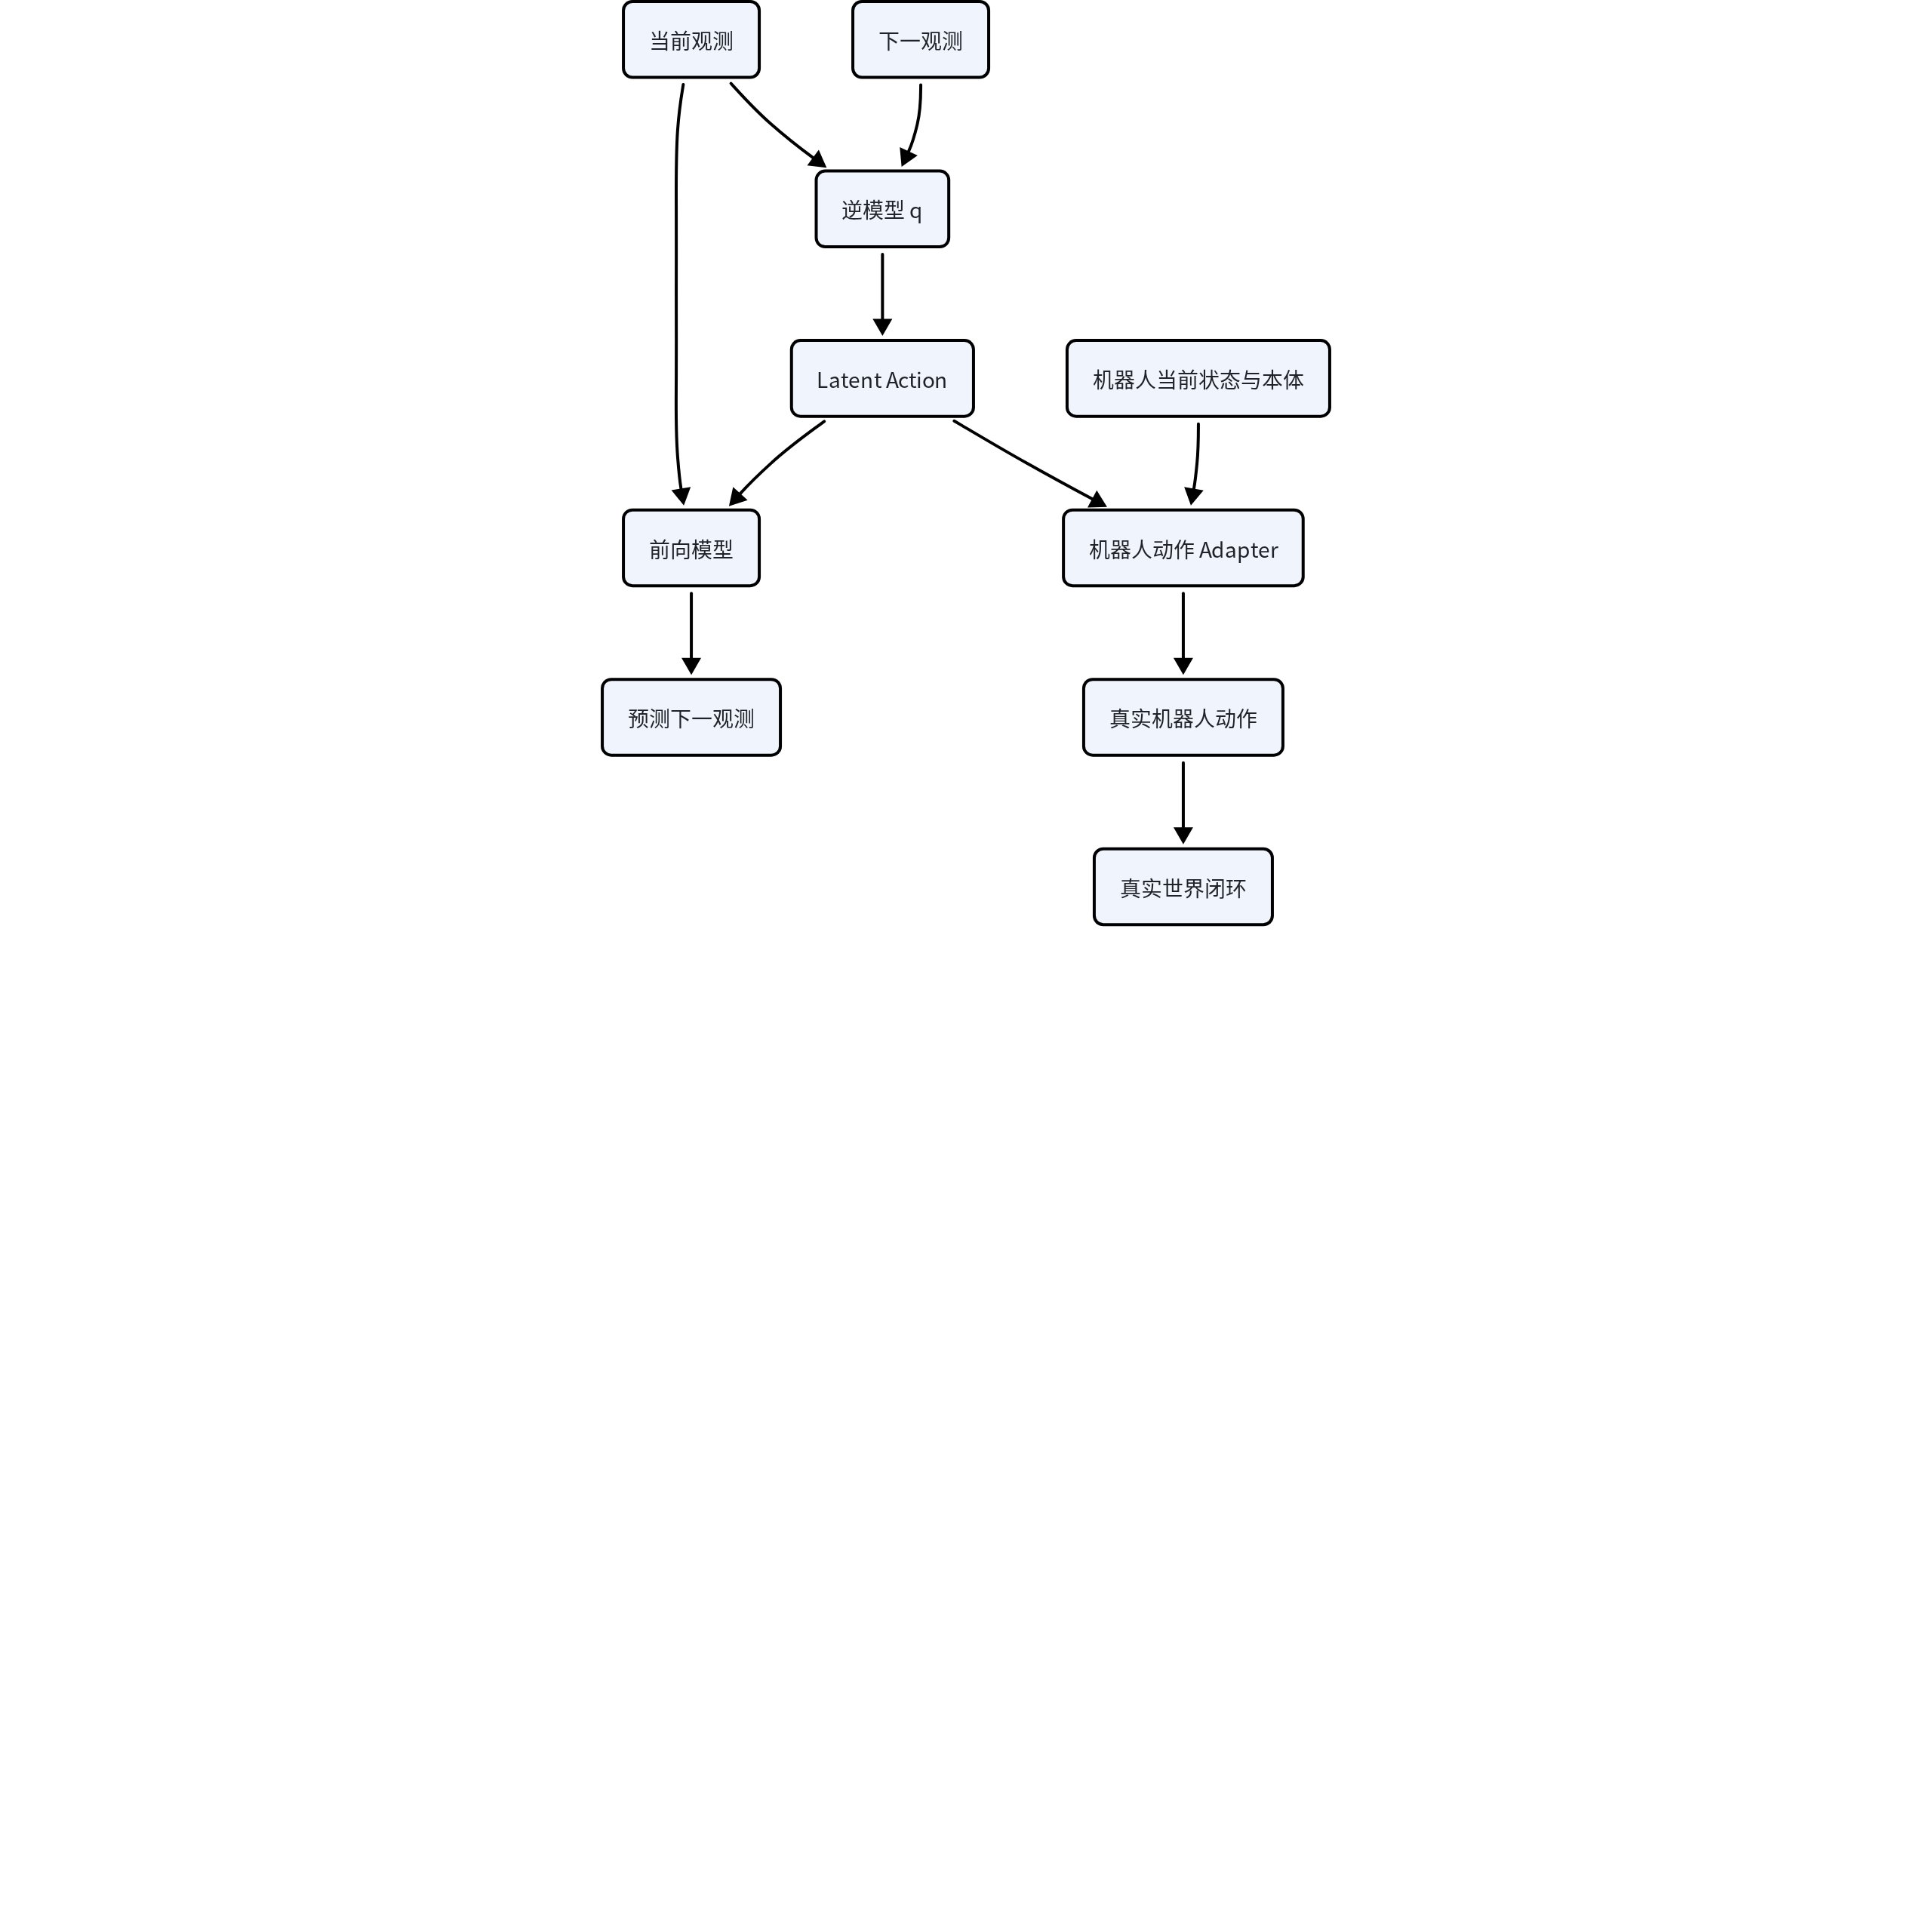
机制课: 人类视频没有机器人动作。Latent Action 试图从前后状态变化推断一个可预测、可离散、可迁移的行为变量,再用少量机器人数据把它落到真实控制。
学习目标
完成本课后,应能写出逆动力学与前向动力学;理解潜在动作不可辨识性;推导变分 latent action 目标;区分视觉变化和可控变化;设计跨本体 adapter 和决定性消融。
1. 逆动力学
若状态和动作可观测:
读法: 逆动力学模型根据当前状态和下一状态,对造成这次变化的动作给出条件分布。
推导: 前向动力学从状态和动作预测下一状态;应用 Bayes 方向反过来,就得到从状态转移推断动作的模型。由于多个动作可能产生相同结果,输出应是分布而非唯一标签。
逆动力学回答“什么动作造成了这次变化”。在机器人数据中可监督训练,再用它给无动作视频产生伪动作。
问题是同一状态变化可能由多种动作造成,观测又可能缺少力和隐藏状态。
2. Latent Action
引入潜变量:
读法: 潜在动作 z_t 从以相邻观测为条件的推断分布中采样。
推导: 真实动作不可见时,把解释观测变化的隐藏因素设为 z_t。推断器利用变化前后两帧估计它,但 z_t 还可能编码相机、光照或其他不可控因素,需要额外约束。
前向模型:
读法: 前向模型根据当前观测和潜在动作,对下一观测建模。
推导: 若 z_t 真能表示导致变化的行为,它与 o_t 一起应足以预测 o_{t+1}。这项约束保证 latent 含有变化信息,但不能单独保证它等价于可执行机器人动作。
训练目标可写为:
读法: 总损失由下一观测的负对数似然和后验偏离先验的 KL 正则组成,beta 控制二者权衡。
推导: 这是条件变分自编码目标的负 ELBO。第一项要求 latent 能解释状态变化,第二项限制编码容量并让空间可采样;beta 过大可能导致后验塌缩,过小则会记住无关像素细节。
重建项让 latent 解释变化,KL 限制编码容量并形成可采样空间。
💡
交互验证|Latent Action、行为 Token 与跨本体表征实验室
改变对象对齐、动作标签、本体差异和坐标归一化,观察共享行为变量能否迁移到不同机器人。
Latent Action、行为 Token 与跨本体表征实验室
:::3. 不可辨识性
如果对 latent 做任意可逆变换 ,同时调整解码器,观测重建可以不变。因此 latent 数值没有天然语义。
需要额外约束:
- 离散 codebook。
- 对象和事件监督。
- 时间连续性和稀疏性。
- 机器人动作对齐。
- 跨视角一致性。
- 任务结果和可控性。
4. 可控变化与不可控变化
视频变化包含相机移动、光照、其他人和背景。Latent Action 应优先编码智能体可控变化。可以用机器人动作数据或 controllability 目标:
读法: 在已知当前观测后,潜在动作与下一观测之间的条件互信息。
推导: 互信息高意味着 z_t 能减少对未来观测的不确定性。但相机移动同样可预测未来像素,所以还需机器人动作干预、对象中心表示或可控性标签把智能体行为与外部变化分开。
但高互信息可能仍编码相机运动,需要对象中心和动作干预。
5. 离散与连续 latent
| 类型 | 优势 | 风险 |
|---|---|---|
| 离散 token | 便于序列模型和技能组合 | 量化与 codebook 塌缩 |
| 连续向量 | 表达精细运动 | 难解释和跨本体 |
| 混合 | 事件 token + 连续参数 | 训练复杂 |
操作任务常适合混合表示:“抓取”是离散事件,接近方向和速度是连续参数。
6. 从 latent 到机器人动作
机器人 adapter:
读法: 机器人动作 adapter 根据机器人当前观测、共享潜在动作和本体标识,对真实机器人动作建模。
推导: 相同功能在不同机器人上需要不同关节和速度,因此 adapter 必须同时读取本体状态与标识 e。固定共享 z、只更换 adapter 的跨机器人实验,才能验证 latent 是否具有可复用功能语义。
表示本体。少量机器人配对数据训练 adapter,使共享 latent 在不同控制接口上解码。
共享 latent 不应包含特定关节值,而应表达对象相对变化、事件或可供性。
7. 伪动作预训练
- 用机器人数据训练逆模型。
- 给人类/互联网视频预测伪动作或 latent。
- 用视频规模预训练行为序列模型。
- 在机器人数据上对齐真实动作。
- 闭环验证。
伪标签误差会系统性传播,必须保留置信度并与无伪动作基线比较。
8. 与世界动作模型
World-Action Model 联合建模状态变化和动作变量,可用于视频预测、测试时记忆和机器人策略。关键问题是 latent 是否既能解释人类视频,也能提升机器人动作。
9. 最小实验:Latent Action 是否具有可控行为语义
在同一对象操作数据上训练视频自编码、latent action、机器人逆动力学伪动作和真实动作监督四种模型。固定视觉骨干、视频数量、机器人动作数据、latent 维度和策略容量。
依次做时间打乱、相机运动、背景变化、对象中心消融、latent 置换和 adapter 换机器人实验。报告下一观测预测、可控变化探针、机器人动作解码、少样本 adapter 曲线、未见本体迁移和真实闭环成功率。
- 时间打乱:latent 是否仍能工作。
- 相机运动对照:是否编码不可控背景。
- 对象中心消融。
- 离散、连续和混合 latent 比较。
- 少量机器人 adapter 的样本效率。
- 闭环成功而非只报告视频重建。
10. 本课练习
- 解释逆动力学的多解性。
- 推导 latent action ELBO。
- 构造 latent 不可辨识变换。
- 设计 controllability 目标。
- 为抓取定义混合离散-连续 latent。
- 说明 WAM-TTT 为什么需要人机 outer loop。
11. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 后验塌缩 | z 与观测无关,前向模型忽略 latent | KL 曲线、latent 置换、free bits 或降低 beta |
| 记住不可控变化 | z 主要编码相机、光照或背景移动 | 相机干预、对象中心输入和机器人动作互信息 |
| 不可辨识 | 不同训练种子得到完全不同坐标,无法跨模型复用 | 事件、动作、结果和跨视角一致性约束 |
| 逆动力学多解 | 伪动作过度自信,给同一转移单一错误标签 | 分布输出、多模态模型和置信度过滤 |
| 伪标签误差放大 | 大规模视频预训练把 IDM 偏差固化进策略 | 保留置信度、无伪动作基线和少量真动作校准 |
| Adapter 记忆数据集 | 训练机器人解码好,换本体或状态后失效 | 本体留出、状态条件和参数共享消融 |
| 重建好但控制差 | 视频指标提升,闭环成功率不变或下降 | 固定机器人数据和控制器,直接报告任务收益 |
12. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| VPT | 用少量有动作 Minecraft 数据训练逆动力学模型,再为大规模视频预测伪动作并预训练策略 | 动作标签可以借助逆模型扩展到无标签视频 | 这是伪动作路线的清晰证据,但依赖同一游戏本体和可观测转移,跨真实机器人更难 |
| Genie | 从互联网视频学习潜在动作模型和可交互生成环境,无需真实动作标签 | 视频中的可控变化可形成离散 latent action | 交互视频生成证明 latent 能控制视觉未来,不自动证明能解码为真实机器人动作 |
| XSkill | 从人类与机器人视频中发现跨本体技能表示并用于下游模仿 | 功能层技能可连接不同身体 | 需要对象状态、事件边界和 adapter 留出证明语义,而非只看 embedding 对齐 |
| WAM-TTT | 人类视频侧信号更新快速记忆,机器人动作任务训练更新规则 | 共享世界-动作结构可支持测试时适应 | 关键是 outer loop 是否让 latent 对机器人控制有用,以及错误上下文能否被拒绝或回滚 |