

飞书原文 · 源修订 34
🎥
核心判断: 普通人类视频没有直接的手部控制速度或机器人动作标签。模型可以从时间序列估计图像运动、相对轨迹和动作阶段,但真实机器人速度、力与控制约束仍必须由机器人数据和控制器完成 grounding。
本文连接两个问题:连续动作概率密度的数学例子,以及人类行为数据如何迁移为机器人可执行控制。
1. 人类视频中实际有什么数据
普通人类视频最基本的数据形式是:
读法: 视频数据 V 由 T 个图像帧与各自时间戳组成。
推导: 相机直接记录的是随时间变化的光学观测。把每帧 I_t 与时间戳 tau_t 配对,才能计算帧间间隔和表观运动;其中仍没有人体控制量、机器人动作、力或接触标签。
其中 是第 帧图像, 是对应时间戳。视频直接记录的是光学观测,不是动作命令。
| 视频中可能存在 | 视频中通常不存在 |
|---|---|
| 图像帧和时间顺序 | 人体真实关节控制命令 |
| 手与对象的视觉位置 | 机器人关节速度和力矩 |
| 对象状态和可见运动 | 真实接触力与摩擦 |
| 动作节奏和任务阶段 | 精确三维尺度与深度 |
| 遮挡、共同运动和结果 | 执行器约束和控制器状态 |
如果采集系统额外提供 RGB-D、多视角、IMU、动作捕捉或手套信号,才能获得更接近真实三维人体运动的测量。
📌
关键边界: 手部轨迹是视频中的行为观测,不是机器人可以直接下发的 action。
2. 如何从图像序列估计运动与速度
专题延伸:从手部关键点到手-物交互表示
手部速度并非原始标签。可先由 21 点骨架恢复手掌坐标系、抓型和相对运动,再结合对象位姿、接触概率与对象状态变化构造可迁移表示。
二维像素速度
如果视频跟踪器得到手部或对象的像素位置 ,可以使用有限差分:
读法: 像素速度估计等于相邻帧像素位置之差除以时间戳之差。
推导: 有限差分用离散位置近似时间导数。分子单位是 pixel,分母单位是秒,所以结果是 pixel 每秒;关键点噪声会被差分放大,因此实际使用前需要跟踪、相机补偿和平滑。
它的单位是 pixel/s,只表示图像平面中的表观运动。
三维速度
如果有深度、相机标定或多视角重建,可以估计三维位置 :
读法: 三维速度估计等于相邻时刻三维位置之差除以时间间隔。
推导: 只有在深度、相机标定或多视角重建提供统一三维坐标后,位置差才具有米等物理单位。若 X_t 仍带尺度歧义,速度也只能是相对尺度速度。
为什么不能直接逐帧相减
关键点估计包含跳变和遮挡,直接差分会放大噪声。实际流程通常为:
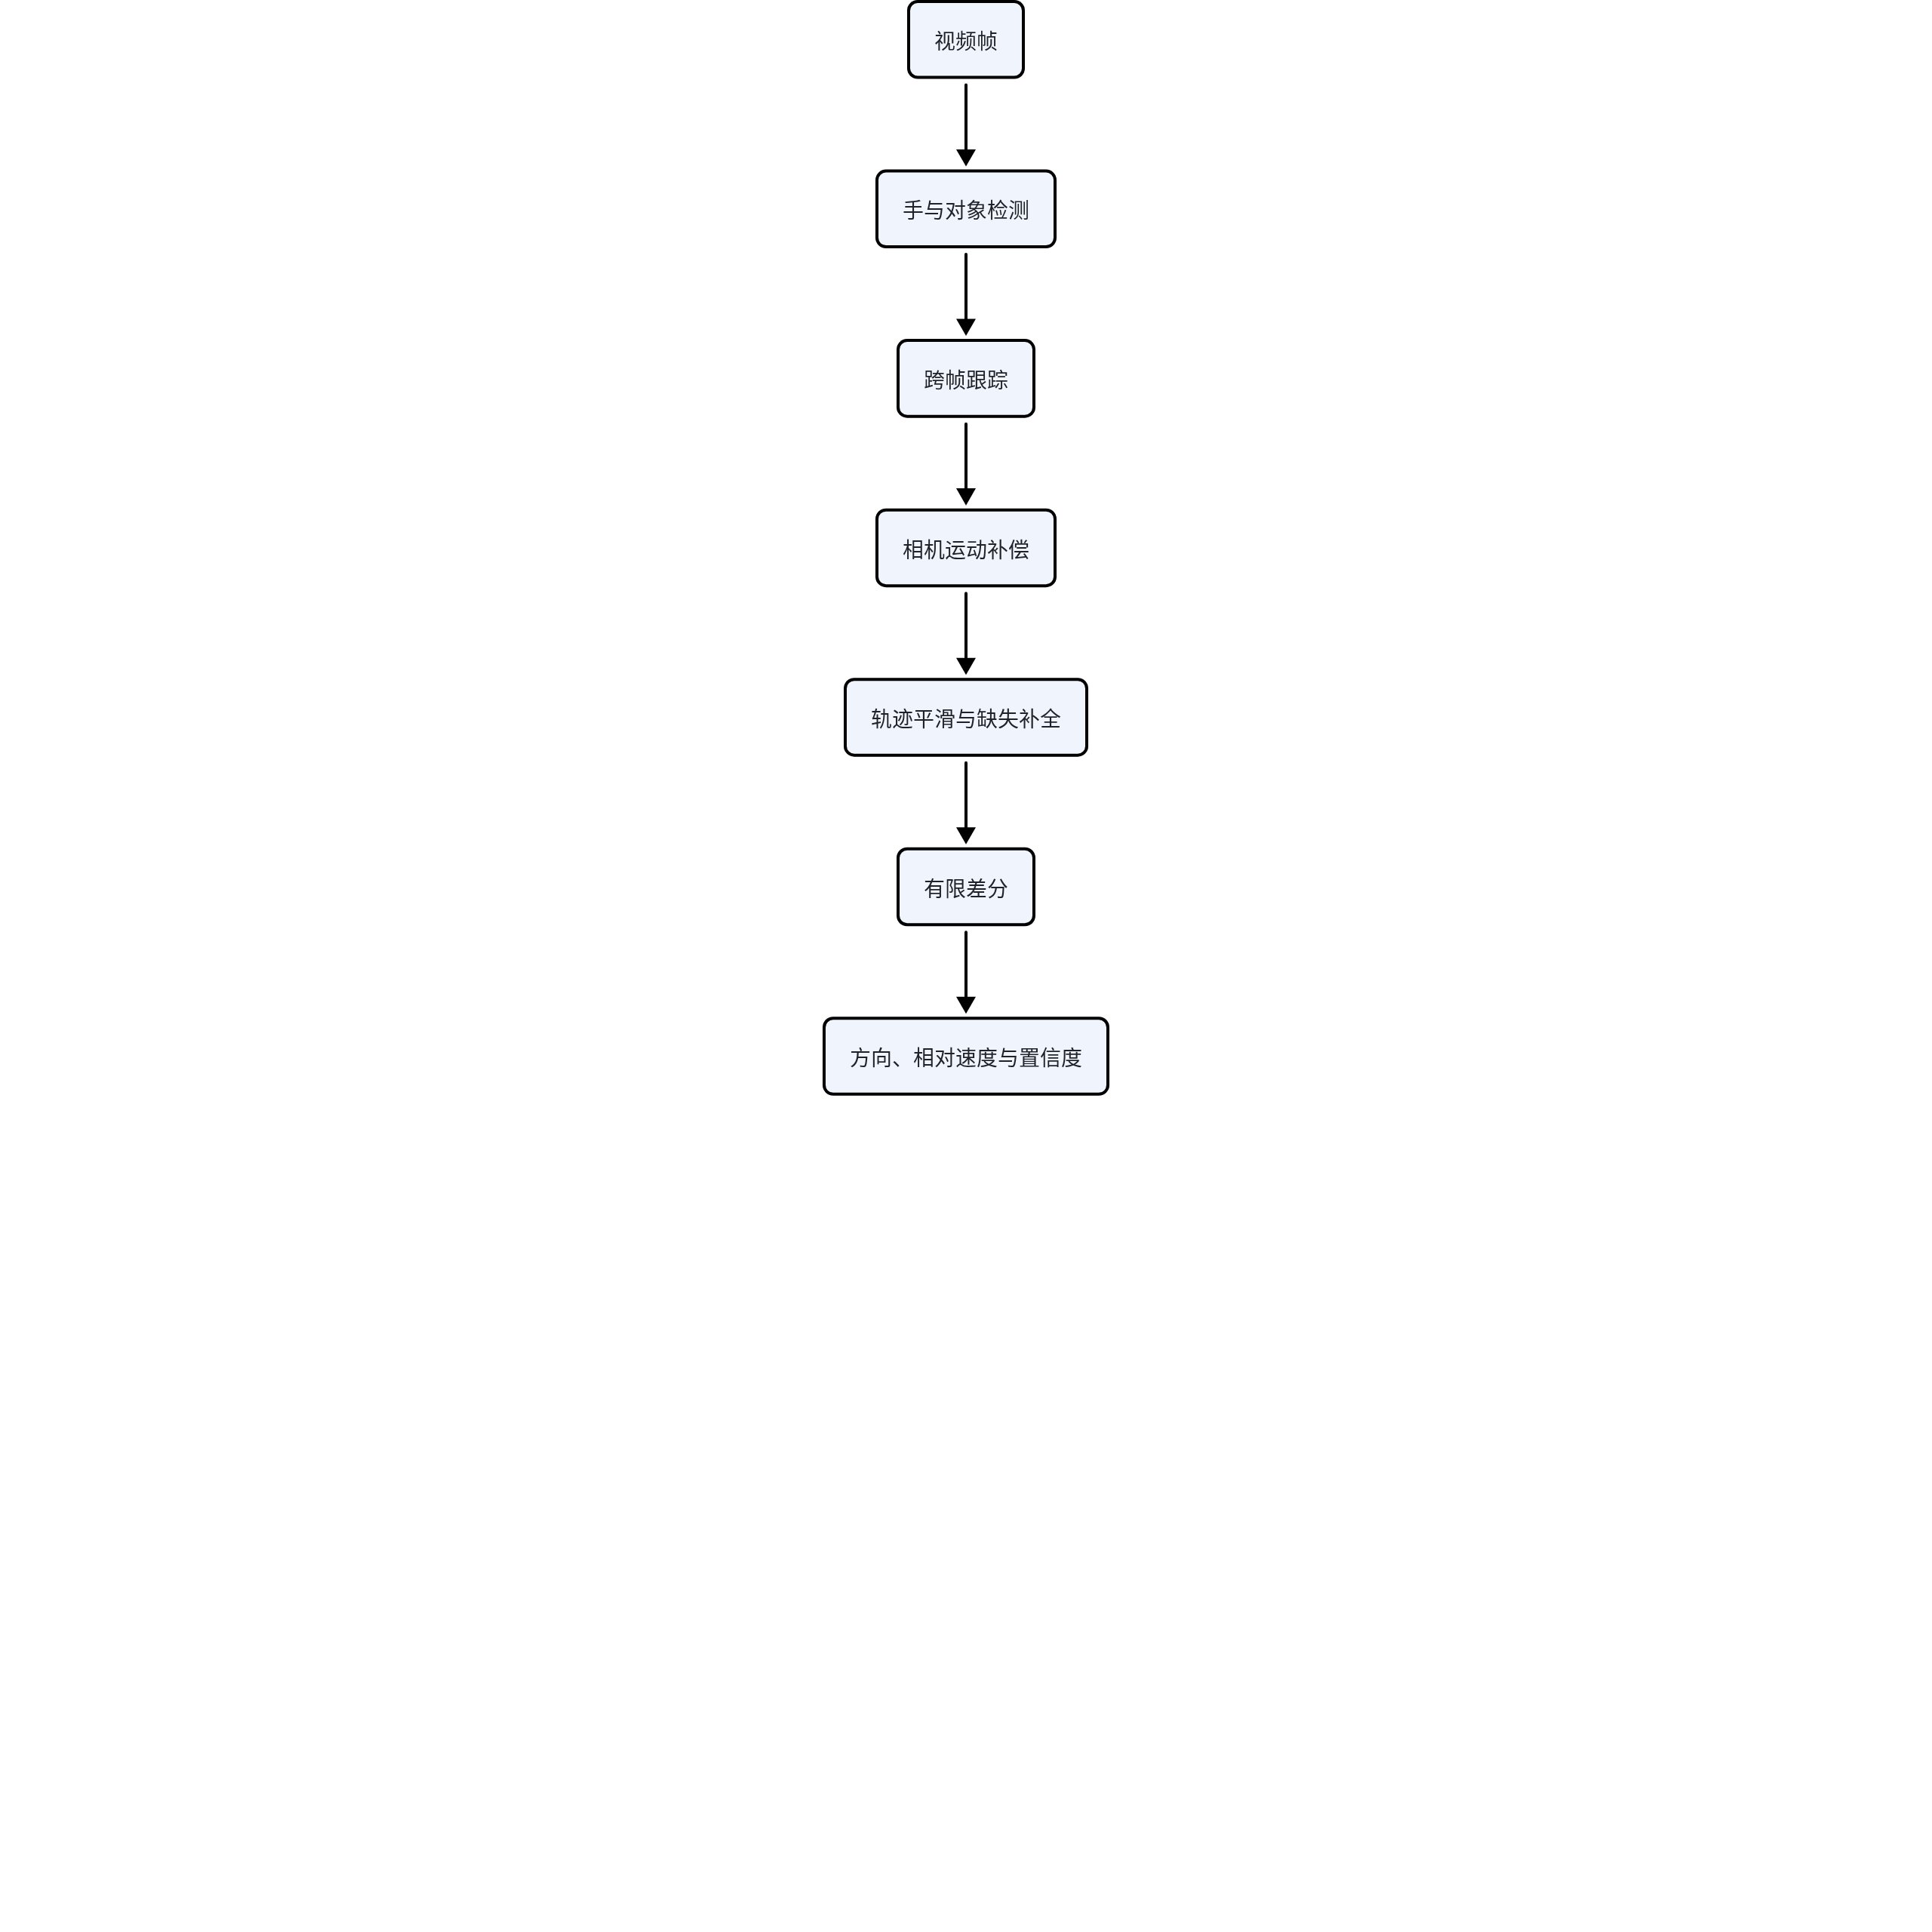
可使用 Kalman Filter、Savitzky-Golay、样条曲线或时序神经网络平滑轨迹。输出时应同时保留位置和速度置信度。
3. 单目视频中的根本歧义
单目视频从二维图像反推三维运动是欠定问题,多个真实运动可能产生相似图像。
| 歧义 | 后果 |
|---|---|
| 深度与尺度 | 无法知道像素位移对应多少厘米 |
| 朝相机方向运动 | 真实位移很大,但二维位移可能很小 |
| 相机自身运动 | 头部或相机晃动会被误认为手部运动 |
| 遮挡 | 手指和接触点在关键时刻不可见 |
| 动作模糊 | 快速动作导致关键点估计不稳定 |
| 帧率不一致 | 没有可靠时间戳就无法比较速度 |
因此单目视频较可靠地提供:
- 运动方向;
- 相对快慢;
- 手-物距离变化;
- 对象是否随手共同运动;
- 动作阶段和事件顺序。
但不能把估计结果直接解释为精确米每秒速度、接触力或机器人控制命令。
4. 视频模型如何在没有速度标签时学习运动
模型不一定需要显式速度标签。只要输入包含时间顺序,它就可以从帧间变化中学习运动表示。
视频预测
读法: 视频模型根据过去图像和语言条件,对未来 H 帧的联合分布建模。
推导: 为了预测未来像素,模型必须利用对象持续性、运动方向、速度节奏和事件阶段。但像素似然只约束视觉未来,不自动恢复真实力、机器人关节命令或可执行性。
要预测未来帧,模型必须隐式估计对象向哪里移动、移动多快以及动作处于哪个阶段。
对比与时序顺序学习
模型可以学习相邻帧比远距离帧更接近,或判断帧的先后顺序,从而形成时间进度表示。
轨迹预测
ATM 等方法直接预测视觉点未来轨迹:
读法: 轨迹模型根据历史图像、当前视觉点和语言任务,预测这些点未来 H 步的位置轨迹。
推导: 与生成整幅图像相比,点轨迹只保留任务相关运动。它能提供方向和相对路径监督,但仍需对象身份、遮挡置信度和机器人数据把视觉轨迹映射为可执行动作。
隐式学习的边界
视频模型可以学习“看起来如何运动”,但不自动恢复:
- 人体肌肉或关节控制量;
- 真实接触力;
- 机器人执行器需要的速度和力矩;
- 动作是否满足目标机器人动力学。
WAM-TTT 采用的也是这一路线:人类视频通过视频预测写入视觉动力学记忆,机器人 Action Expert 仍由配对机器人动作数据完成 grounding。
5. 为什么人手速度不能直接作为机器人动作
即使能够准确估计人体手部速度:
即使能够从视频估计人体手部在世界坐标或归一化坐标中的速度,也仍然没有得到目标机器人的动作命令。
也不能直接令:
读法: 机器人速度不能直接等同于人体手部速度。
推导: 两者的坐标系、尺度、自由度、控制频率、动力学和安全约束不同。可共享的是任务功能、相对方向和事件节奏,具体速度必须由机器人状态、控制器和机器人动作数据重新求解。
因为人和机器人存在本体鸿沟:
- 手臂长度和关节拓扑不同;
- 工作空间和奇异位形不同;
- 人手、两指夹爪和灵巧手的抓型不同;
- 最大速度、加速度和力矩不同;
- 控制频率和延迟不同;
- 负载、顺应性和碰撞约束不同。
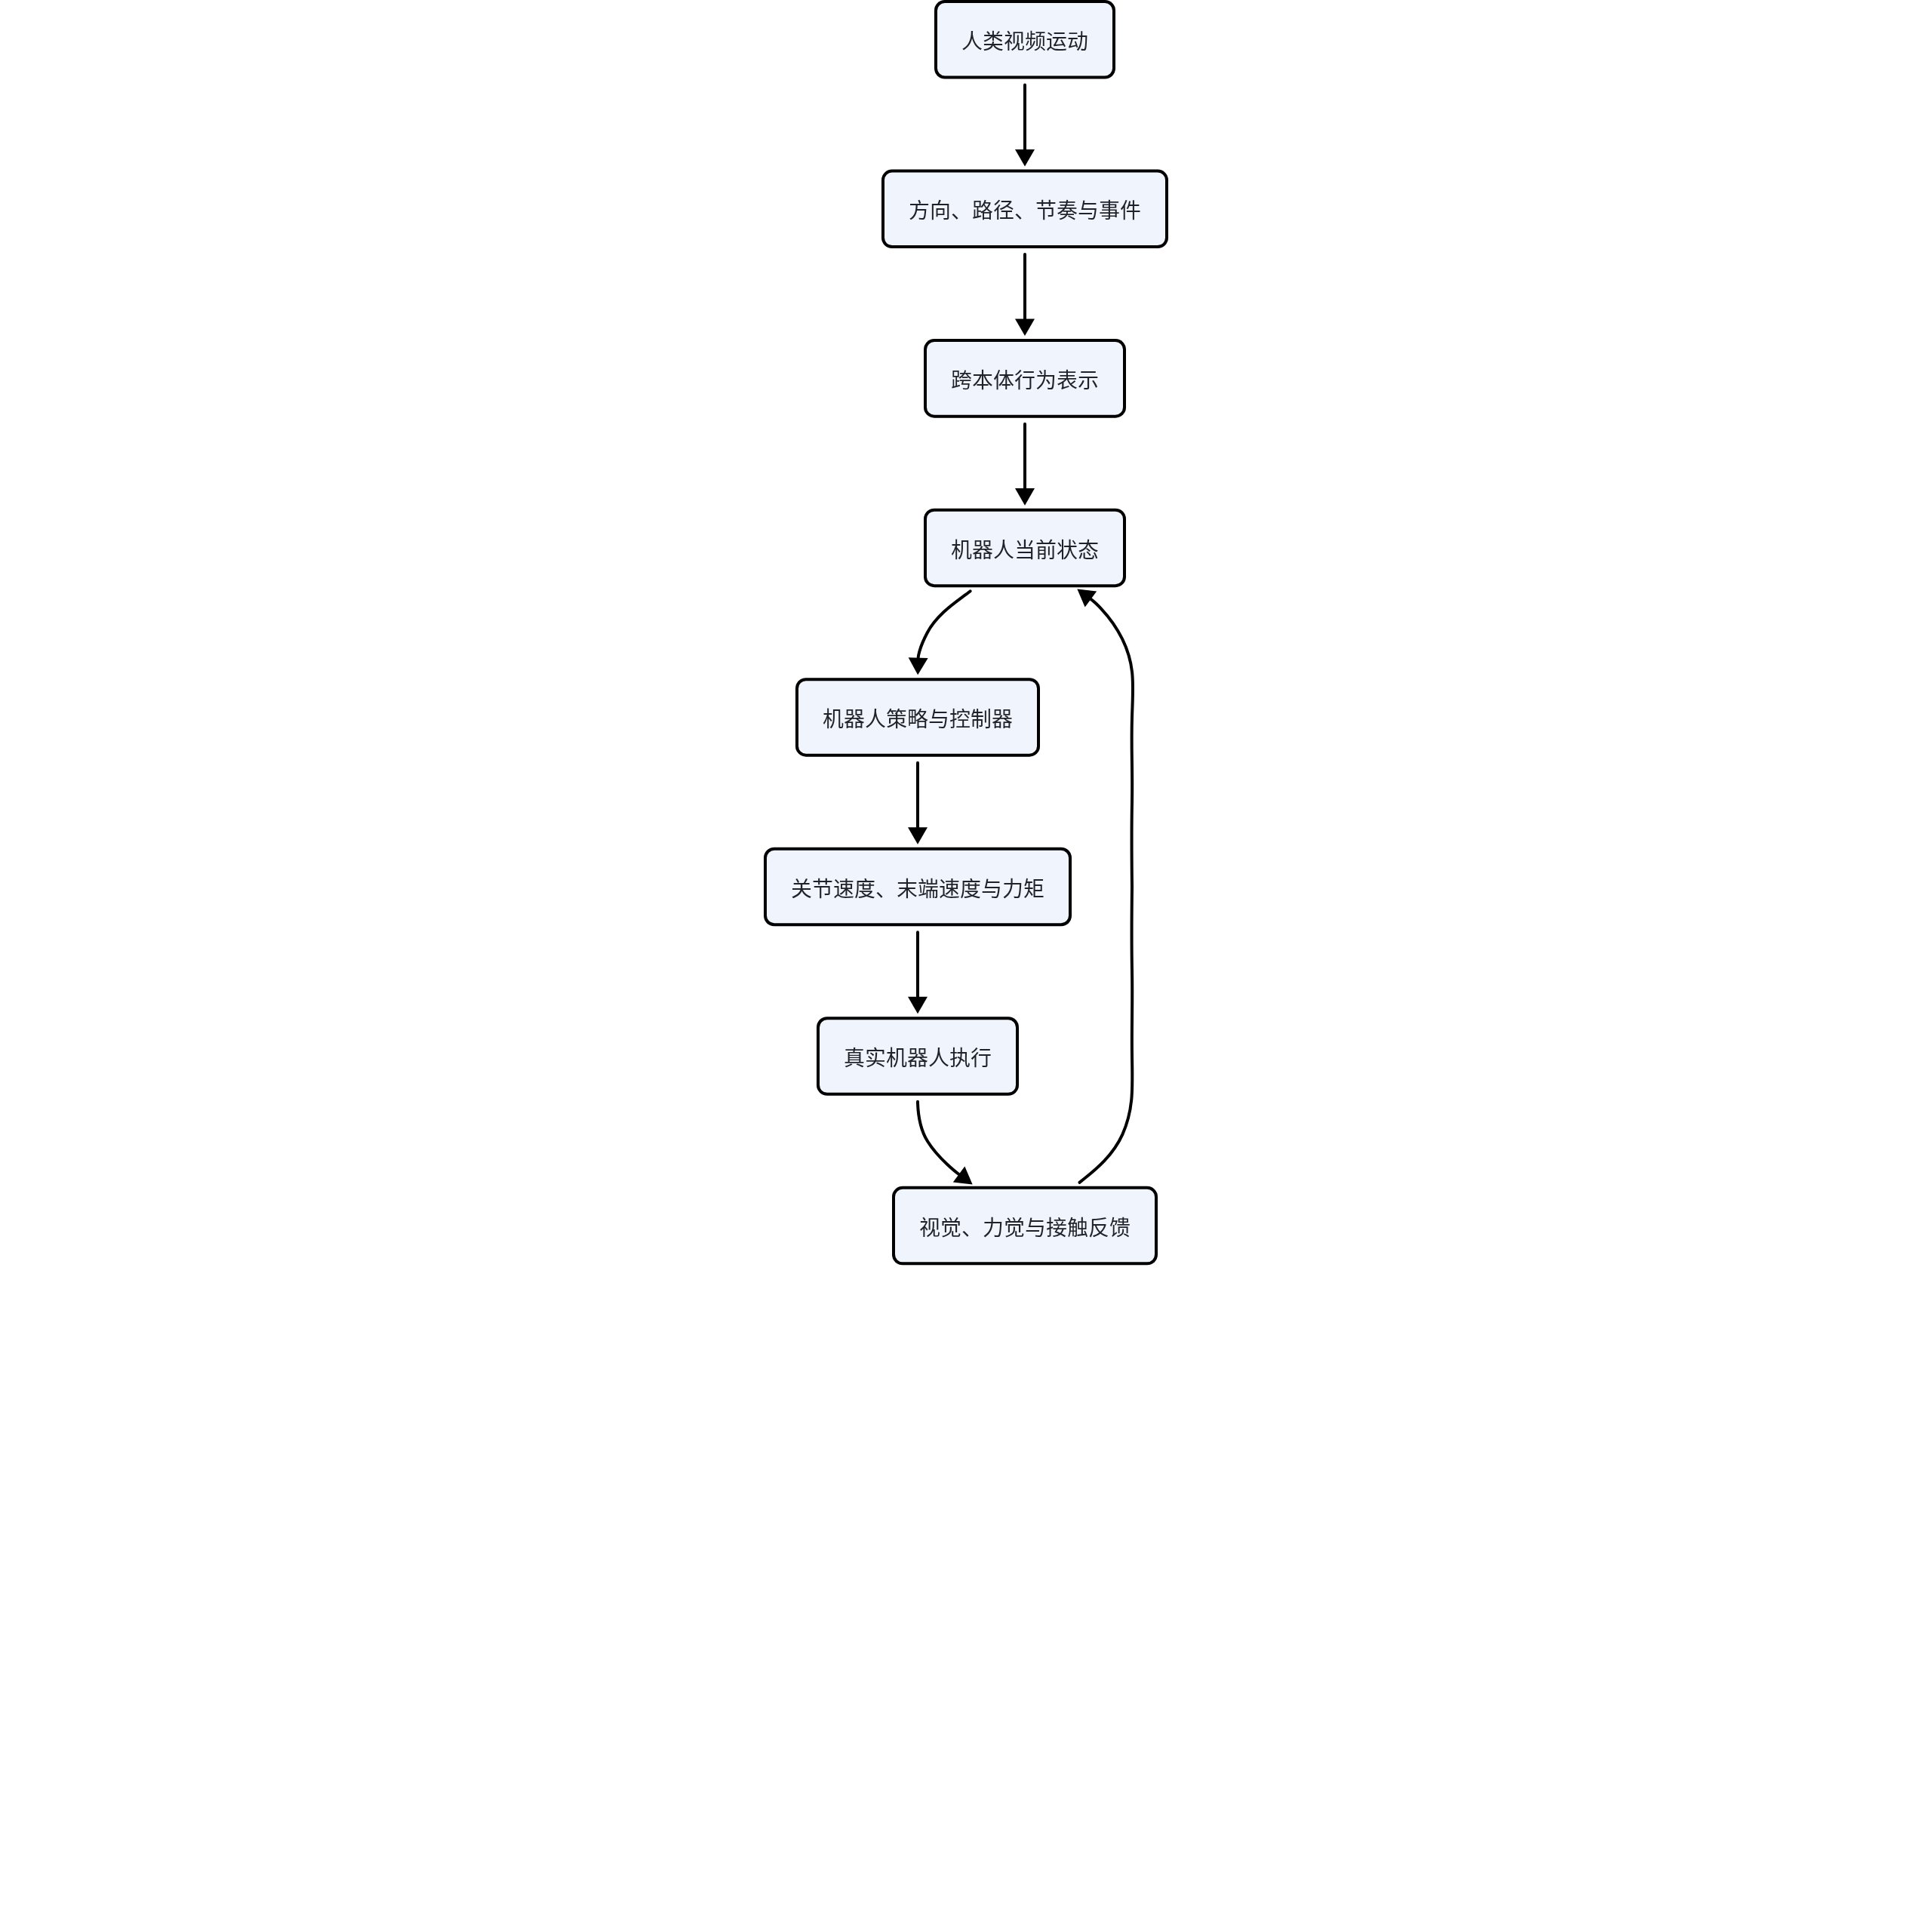
人类数据更适合监督“做什么、沿什么相对路径、何时接触”;机器人数据负责监督“当前本体具体输出多少速度、位置和力”。
6. 推荐的对象中心与归一化表示
跨本体共享时,优先表示对象相对量,而不是人体世界坐标绝对速度。
对象相对位移
读法: 手相对物体的位置等于手的位置减去物体的位置。
推导: 同时平移手和物体不会改变这个差,因此相对位置比场景绝对坐标更适合描述接近、抓取和放置。若需跨视角稳定,还应把差向量变换到对象坐标系。
尺度归一化速度
读法: 尺度归一化相对速度等于手-物相对位置的变化,除以时间间隔和对象尺度。
推导: 先对相对位置做差可以扣除对象自身运动,再除以时间得到相对速度,最后除以对象尺度消除大小差异。它表达“每秒移动了多少个对象尺度”,而不是米每秒。
其中 是对象尺度。该量表示单位时间内,手相对于对象尺寸移动了多少。
方向和速度等级
在数据质量有限时,可以避免回归精确数值,改为:
[APPROACH direction=left speed=slow]
[CONTACT speed=decelerating]
[LIFT speed=steady]
[PLACE speed=slowing_down]
任务 phase
还可以将每段行为映射到归一化进度:
读法: 任务阶段变量 phi_t 位于零到一之间,零表示阶段开始,一表示阶段结束。
推导: 把不同持续时间的演示按事件边界归一化到共同区间,可以比较动作节奏与阶段进度。但同一 phase 可能对应不同路径和速度,因此不能把它当成控制量。
但 phase 只能表示任务进度,不能替代真实速度。更稳妥的 Prompt 同时包含对象轨迹、事件边界和相对节奏。
7. 接触丰富任务需要哪些额外信号
对于自由空间接近和普通搬运,RGB 轨迹可能已经提供较强监督。但以下任务只靠视频通常不够:
- 插接与装配;
- 旋拧瓶盖和螺丝;
- 擦拭与刮削;
- 柔性物体操作;
- 易碎对象抓取;
- 需要控制法向力的工具使用。
| 额外信号 | 解决的问题 |
|---|---|
| RGB-D / 多视角 | 三维尺度、深度和遮挡 |
| 相机或头部位姿 | 补偿第一视角相机运动 |
| 手套 / IMU / Mocap | 高频手指和手臂运动 |
| 对象 6D Pose | 对象相对运动和旋转 |
| 机器人力/力矩 | 接触力和动力学 grounding |
| 触觉 | 滑移、接触分布和抓取稳定性 |
务实方案是使用大量低成本 RGB 人类视频学习行为结构,再使用少量高质量多模态人类数据和真实机器人交互完成校准。
8. 推荐的数据与训练管线
推荐训练分工
- 人类视频预训练运动、对象关系和任务阶段编码器。
- 使用少量人机配对数据对齐相同任务和事件。
- 使用机器人动作监督训练真实 Action Head。
- 使用机器人力觉和触觉数据训练接触阶段。
- 部署时由人类 Prompt 指定行为结构,由机器人当前状态决定具体速度。
标签可信度
人类视频派生速度应保存为估计量:
{
  "motion_direction": "left",
  "normalized_speed": 0.42,
  "speed_confidence": 0.68,
  "source": "monocular_track_v2",
  "metric_scale_available": false
}
不能把单目估计结果当成真实 metric velocity。
9. 一维高斯例子应该如何改写
原来的一维高斯速度例子适合解释连续概率密度,但放在人类视频上下文中容易让人误以为数据包含真实手部速度。
更严谨的写法一:机器人末端速度
如果讨论机器人动作数据,可以明确写成:
读法: 在条件 c 下,机器人一维速度被建模为均值 mu、方差 sigma 平方的高斯随机变量。
推导: 机器人控制日志提供有物理单位的速度样本;用样本均值和方差描述其条件分布,可教学连续概率密度与不确定性。高斯只是简化模型,多峰动作应使用混合分布或生成式策略。
这里的速度来自机器人控制日志,具有真实单位和动作语义。
更严谨的写法二:人类视频的归一化相对速度
如果讨论人类视频,应写成:
读法: 在条件 c 下,人类视频派生的归一化相对速度被近似为高斯分布。
推导: 这里的样本来自跟踪、时间戳和对象尺度计算,带有估计误差而非真实控制日志。分布描述的是相对运动节奏,应同时保存置信度和是否具有 metric scale。
并定义:
这里沿用第 6 节的尺度归一化相对速度定义:先计算手相对物体的位置变化,再除以时间间隔与对象尺度。
它表达的是手相对于对象尺度的运动节奏,不是机器人需要执行的绝对速度。
更简单的教学例子
如果目的只是说明概率密度,可以直接使用“归一化一维动作变量”:
读法: 在条件 c 下,归一化一维行为变量 z 被建模为高斯分布。
推导: 把教学变量写成无特定单位的 z,可以专注解释概率密度、均值和方差,而不暗示人类视频含有机器人速度标签。z 可代表归一化位移、轨迹系数或 latent action。
其中 可以是归一化位置增量、轨迹系数或 latent action,避免暗示特定数据模态。
10. 最终结论
| 问题 | 回答 |
|---|---|
| 人类视频有没有手部速度标签? | 普通 RGB 视频没有直接标签,只能从时间序列估计 |
| 模型能否学习运动? | 可以学习图像运动、相对轨迹、节奏和任务阶段 |
| 能否恢复真实三维速度? | 单目通常不能;需要深度、标定、多视角或穿戴设备 |
| 人体速度能否直接给机器人? | 不能,本体、执行器和动力学不同 |
| 机器人实际速度从哪里来? | 机器人示范、Action Head、控制器和闭环反馈 |
| 跨本体应该共享什么? | 对象关系、路径方向、事件顺序和归一化节奏 |
✅
最终结论: 人类视频负责提供“运动看起来如何、任务如何展开”;机器人数据负责提供“当前本体具体怎样以正确速度、力和控制频率执行”。两者通过对象中心行为表示连接,而不是直接复制人体速度。
11. 最小实验:视频运动估计是否真正帮助机器人
采集同一批操作同时具有单目 RGB、RGB-D 或多视角三维轨迹,以及机器人复现数据的任务。只向训练管线提供单目 RGB,保留三维轨迹作为评测真值,而不是训练标签。
- 比较原始帧差、跟踪加平滑、相机补偿、对象中心相对轨迹和轨迹预测模型。
- 分别预测像素速度、尺度归一化相对速度、动作阶段和未来点轨迹。
- 把这些表示作为同一机器人策略的预训练或条件输入,固定机器人演示数量和控制器。
- 在新视角、新对象尺度、移动相机和对象自身运动条件下测试。
- 对接触任务增加力觉或触觉对照,验证 RGB 表示的边界。
最低报告项: 二维跟踪误差、三维方向误差、尺度归一化速度误差、阶段识别、置信度校准、机器人闭环成功率、滑动率、力峰值,以及相同机器人数据量下的净提升。
12. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 把像素速度当物理速度 | 换深度、焦距或裁剪后数值失效 | 报告单位、相机标定和 metric scale 是否可用 |
| 相机运动泄漏 | 静止对象被预测为整体移动 | 相机运动补偿、背景点对照和固定相机消融 |
| 差分放大噪声 | 关键点轻微抖动产生巨大速度尖峰 | 轨迹平滑、异常值拒绝和速度置信区间 |
| 忽略对象自身运动 | 手和对象共同移动时仍估计较大相对速度 | 对手-物相对位置做差,而非只差手位置 |
| 遮挡与身份跳变 | 跟踪器换手、换物体或跨遮挡连接错误 | 对象身份一致性、轨迹分段和不确定性门控 |
| 跨本体直接复制 | 人体轨迹映射为机器人速度后碰撞、超限或失稳 | 机器人状态条件、可达性、逆运动学与控制约束 |
| 只看视频指标 | 轨迹预测更准,但机器人任务没有改善 | 固定机器人数据和控制预算,报告真实闭环收益 |
| 接触信息缺失 | 插接、擦拭或易碎抓取的视觉轨迹正确但力控制失败 | 力觉、触觉、接触事件和滑动率评测 |
13. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| R3M | 从大规模第一视角人类视频学习视觉表征,并迁移到机器人操作任务 | 人类视频包含可复用的交互与对象信息 | 证明的是表征迁移,不是从视频恢复了真实机器人速度或力 |
| MimicPlay | 使用人类 play 视频形成高层引导,并结合少量机器人演示学习长时操作 | 人类视频可提供任务结构和运动先验 | 机器人动作 grounding 仍来自机器人数据;应固定机器人演示量验证净收益 |
| ATM | 从视频条件预测任意视觉点的未来轨迹,并将轨迹用于策略学习 | 点轨迹比整幅视频更紧凑地表达运动意图 | 轨迹是观测空间监督;对象身份、遮挡、接触和机器人可达性仍需额外处理 |
| WAM-TTT | 利用人类视频侧信号在测试时更新快速记忆,机器人动作任务监督更新规则 | 当前环境的人类演示可以帮助机器人快速适应 | 关键证据是严格留出、错误演示对照、人机阶段对齐和机器人闭环提升 |
14. 本课练习与交叉阅读
- 解释为什么相同世界速度在不同深度会产生不同像素速度。
- 推导手-物相对速度,并说明为什么要扣除对象自身运动。
- 设计一个区分相机运动与对象运动的实验。
- 说明归一化 phase、相对速度和机器人动作各自表达什么。
- 设计一个证明视频预训练改善机器人闭环而非只改善视频预测的消融。