

飞书原文 · 源修订 29
💡
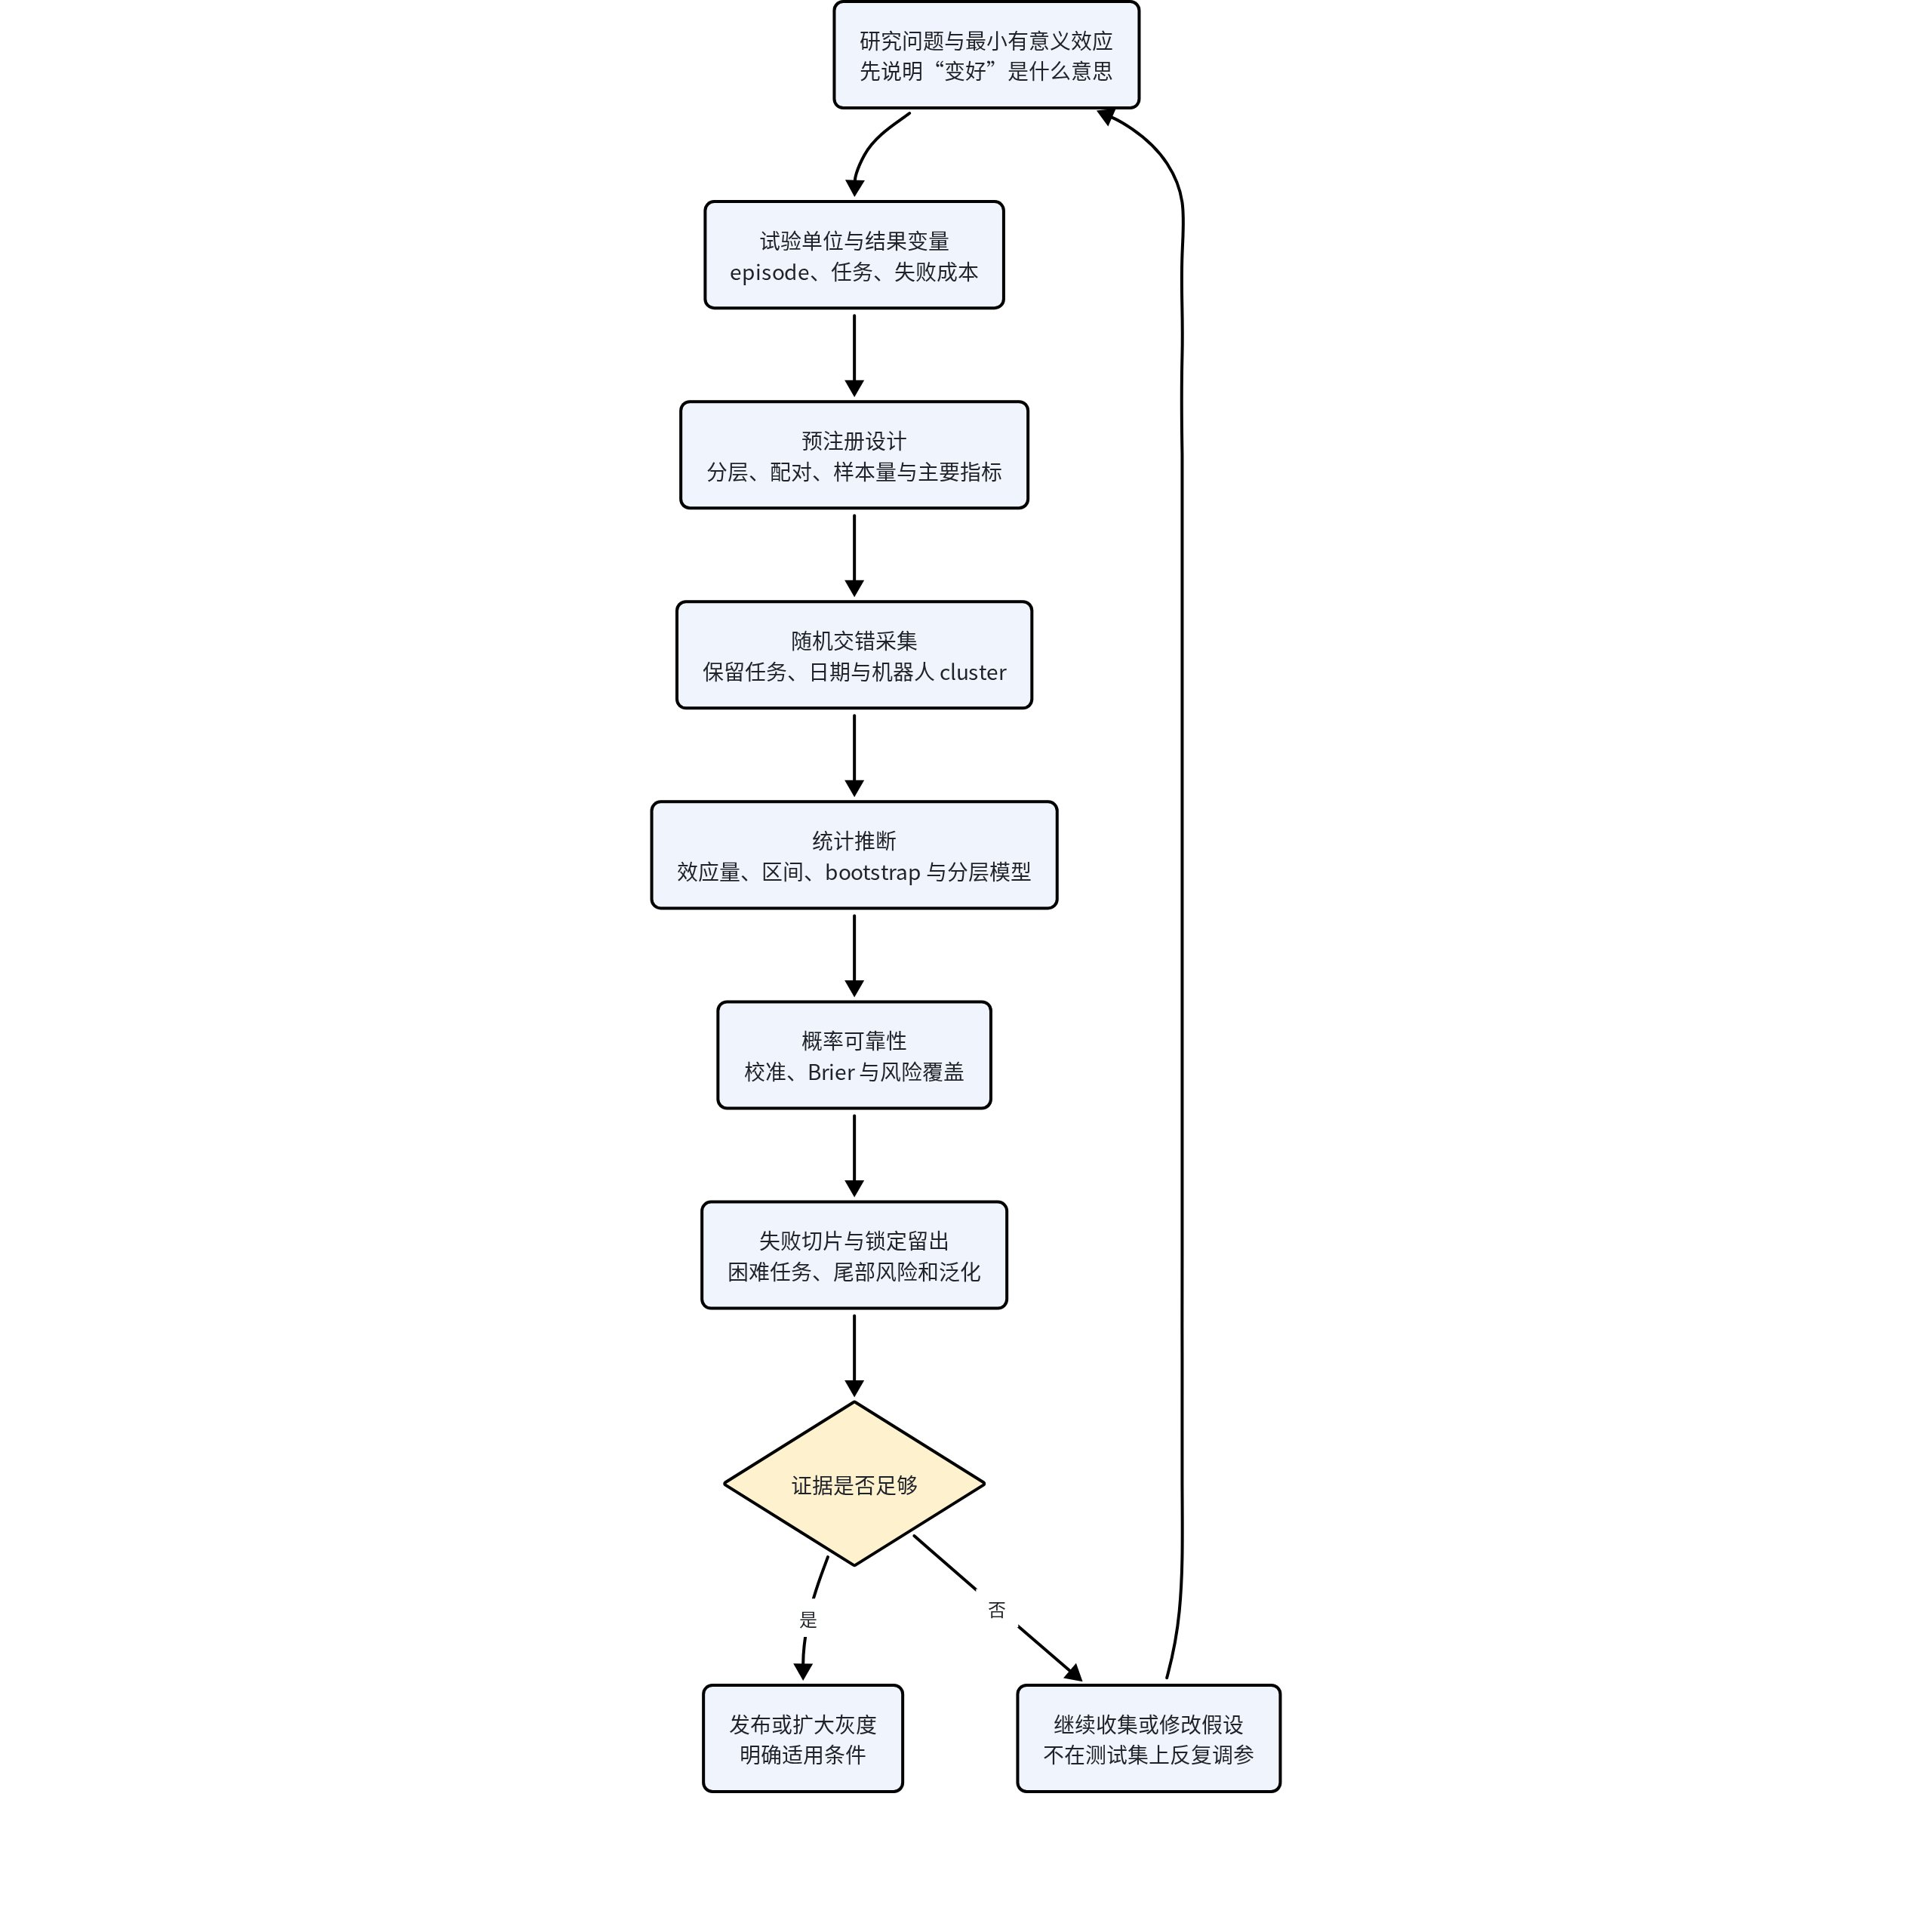
机制课: “成功率从 70% 提升到 80%”不是结论,除非说明试验单位、样本量、任务分层、随机种子、置信区间、失败代价和选择过程。本课把机器人评测还原成统计推断问题。
学习目标
完成本课后,应能定义独立试验单位;推导 Bernoulli 成功率估计与标准误;使用 Wilson 区间和 Beta-Binomial;处理任务分层、重复测量和多重比较;解释校准、选择性预测与风险覆盖曲线。
1. 先定义随机变量
单次试验成功记为:
读法: 第 i 次试验结果是成功概率为 p 的 Bernoulli 随机变量,成功取一,失败取零。
推导: 当一次试验只保留成功或失败两种互斥结果时,其概率质量函数由单个参数 p 决定。这个模型要求先固定试验分布;若任务、对象和初始条件随批次改变,p 应写成条件化或分层参数,而不是假设一个全局常数。
样本成功率:
读法: 经验成功率是 n 次二元试验结果的样本均值。
推导: 因为每个 Y_i 成功时为一、失败时为零,求和正好等于成功次数 k,所以样本均值等于 k 除以 n。在独立同分布 Bernoulli 模型下,它也是 p 的最大似然估计。
这个估计只对应已经定义清楚的试验分布。如果任务、物体、操作者和初始状态每天都变化,单个全局成功率会把条件差异混进同一个参数,应改为分层报告或条件模型。
2. 为什么 8/10 证据很弱
独立同分布假设下:
读法: 独立 Bernoulli 试验的经验成功率方差,等于成功概率乘失败概率再除以样本数。
推导: 单个 Bernoulli 变量方差为 p 乘一减 p。独立变量求和时方差相加,样本均值还要除以 n 的平方,因此得到 n 乘单次方差再除以 n 平方。试验相关时会出现协方差项,有效样本量小于名义次数。
用 代替 得标准误。样本少时正态近似很差,尤其成功率接近 0 或 1。Wilson 区间中心为:
读法: Wilson 区间中心是经验成功率加有限样本修正后,再除以相应归一化因子。
推导: 从二项比例的 score test 出发,把标准化误差不超过 z 的不等式对未知 p 求解,会得到一个二次不等式;两个根的中点就是该式。它把极端小样本估计适度拉向区间内部。
半宽为:
读法: Wilson 区间半宽由置信水平、样本比例方差和有限样本修正共同决定。
推导: 继续求解 score test 的二次不等式,两个根之差的一半就是 h,因此置信区间为中心减 h 到中心加 h。随着 n 增大,修正项衰减并逐渐接近常见大样本近似。
Wilson 区间比直接用经验比例加减 1.96 个标准误的 Wald 区间更适合小样本和极端成功率,但它仍依赖独立试验假设;任务内相关性应通过 cluster bootstrap 或分层模型处理。
3. Bayesian 读法:Beta-Binomial
设先验 ,观察到 次成功、 次失败,则:
读法: 观察到 s 次成功和 f 次失败后,成功概率的后验仍是 Beta 分布,两个形状参数分别加上成功和失败计数。
推导: Bernoulli 数据似然与 p 的 s 次方乘一减 p 的 f 次方成正比,Beta 先验与 p 的 alpha 减一次方乘一减 p 的 beta 减一次方成正比。相乘后指数直接相加,因此得到共轭后验。
Beta-Binomial 便于计算两种方法成功率谁更高的后验概率,但先验、试验可交换性和数据选择过程必须透明。不同任务拥有不同成功率时,应进一步使用分层 Beta-Binomial,而不是把所有计数直接相加。
4. 试验为什么不独立
同一机器人、同一场景连续跑 100 次,可能共享温度、光照、标定和磨损。有效样本量低于 100。应把日期、机器人、任务、对象或操作者视为 cluster,并使用分层 bootstrap、混合效应模型或按 cluster 汇总。
一个简单分层 logistic 模型:
读法: 第 j 个任务或场景中第 i 次试验的成功对数优势,由总体截距、方法效应和该任务的随机难度偏移相加决定。
推导: 二元结果用 logistic 链接把线性预测量映射为零到一的概率。把任务级未观测难度写成均值为零的随机截距,可让同一任务内试验共享相关性,同时用 beta_1 估计跨任务平均方法差异。
随机效应表示任务或场景共享的难度偏移。它避免把“某方法碰巧在简单任务上测试更多”误认为算法收益,也能估计任务之间的异质性;任务数太少时,随机效应方差本身会很不稳定。
💡
交互验证|Wilson 区间、校准与风险覆盖实验室
改变试验次数、成功率和校准程度,观察 Wilson 区间宽度、失校准风险与安全覆盖。
:::5. 配对实验比独立比较更有力
若 A、B 两种方法在相同初始状态、对象和扰动上测试,可分析每对结果差值,消除场景难度噪声。二元结果可用 McNemar 检验;连续指标可用配对 bootstrap。配对成立的前提是测试顺序、磨损和环境记忆不会系统偏向某一方法。
对同一测试条件下 A、B 的二元结果,只比较两种方法不一致的配对。记 A 失败而 B 成功为 n_01,A 成功而 B 失败为 n_10:
读法: 带连续性修正的 McNemar 统计量,用两类不一致配对数量之差的平方,除以不一致配对总数。
推导: 原假设下,两种不一致方向应等概率出现,所以在给定不一致总数时,n_01 服从成功概率二分之一的二项分布。大样本把这个二项偏离标准化为卡方统计量;不一致配对很少时应直接使用精确二项检验。
6. 不只报告显著性
| 必须报告 | 回答的问题 |
|---|---|
| 效应量 | 实际提升多大 |
| 置信/可信区间 | 不确定范围多宽 |
| 样本与分层 | 证据来自哪里 |
| 失败成本 | 提升是否以碰撞或接管换来 |
| 预设主指标 | 是否从许多指标中挑最好看的 |
7. 多重比较与排行榜过拟合
同时试很多 checkpoint、prompt、随机种子和任务切片,再只报告最好结果,会产生选择偏差。应分离开发集与最终锁定测试集;记录全部实验;必要时控制 family-wise error 或 false discovery rate。最重要的是限制反复查看最终测试集。
8. 校准:置信度能否对应真实频率
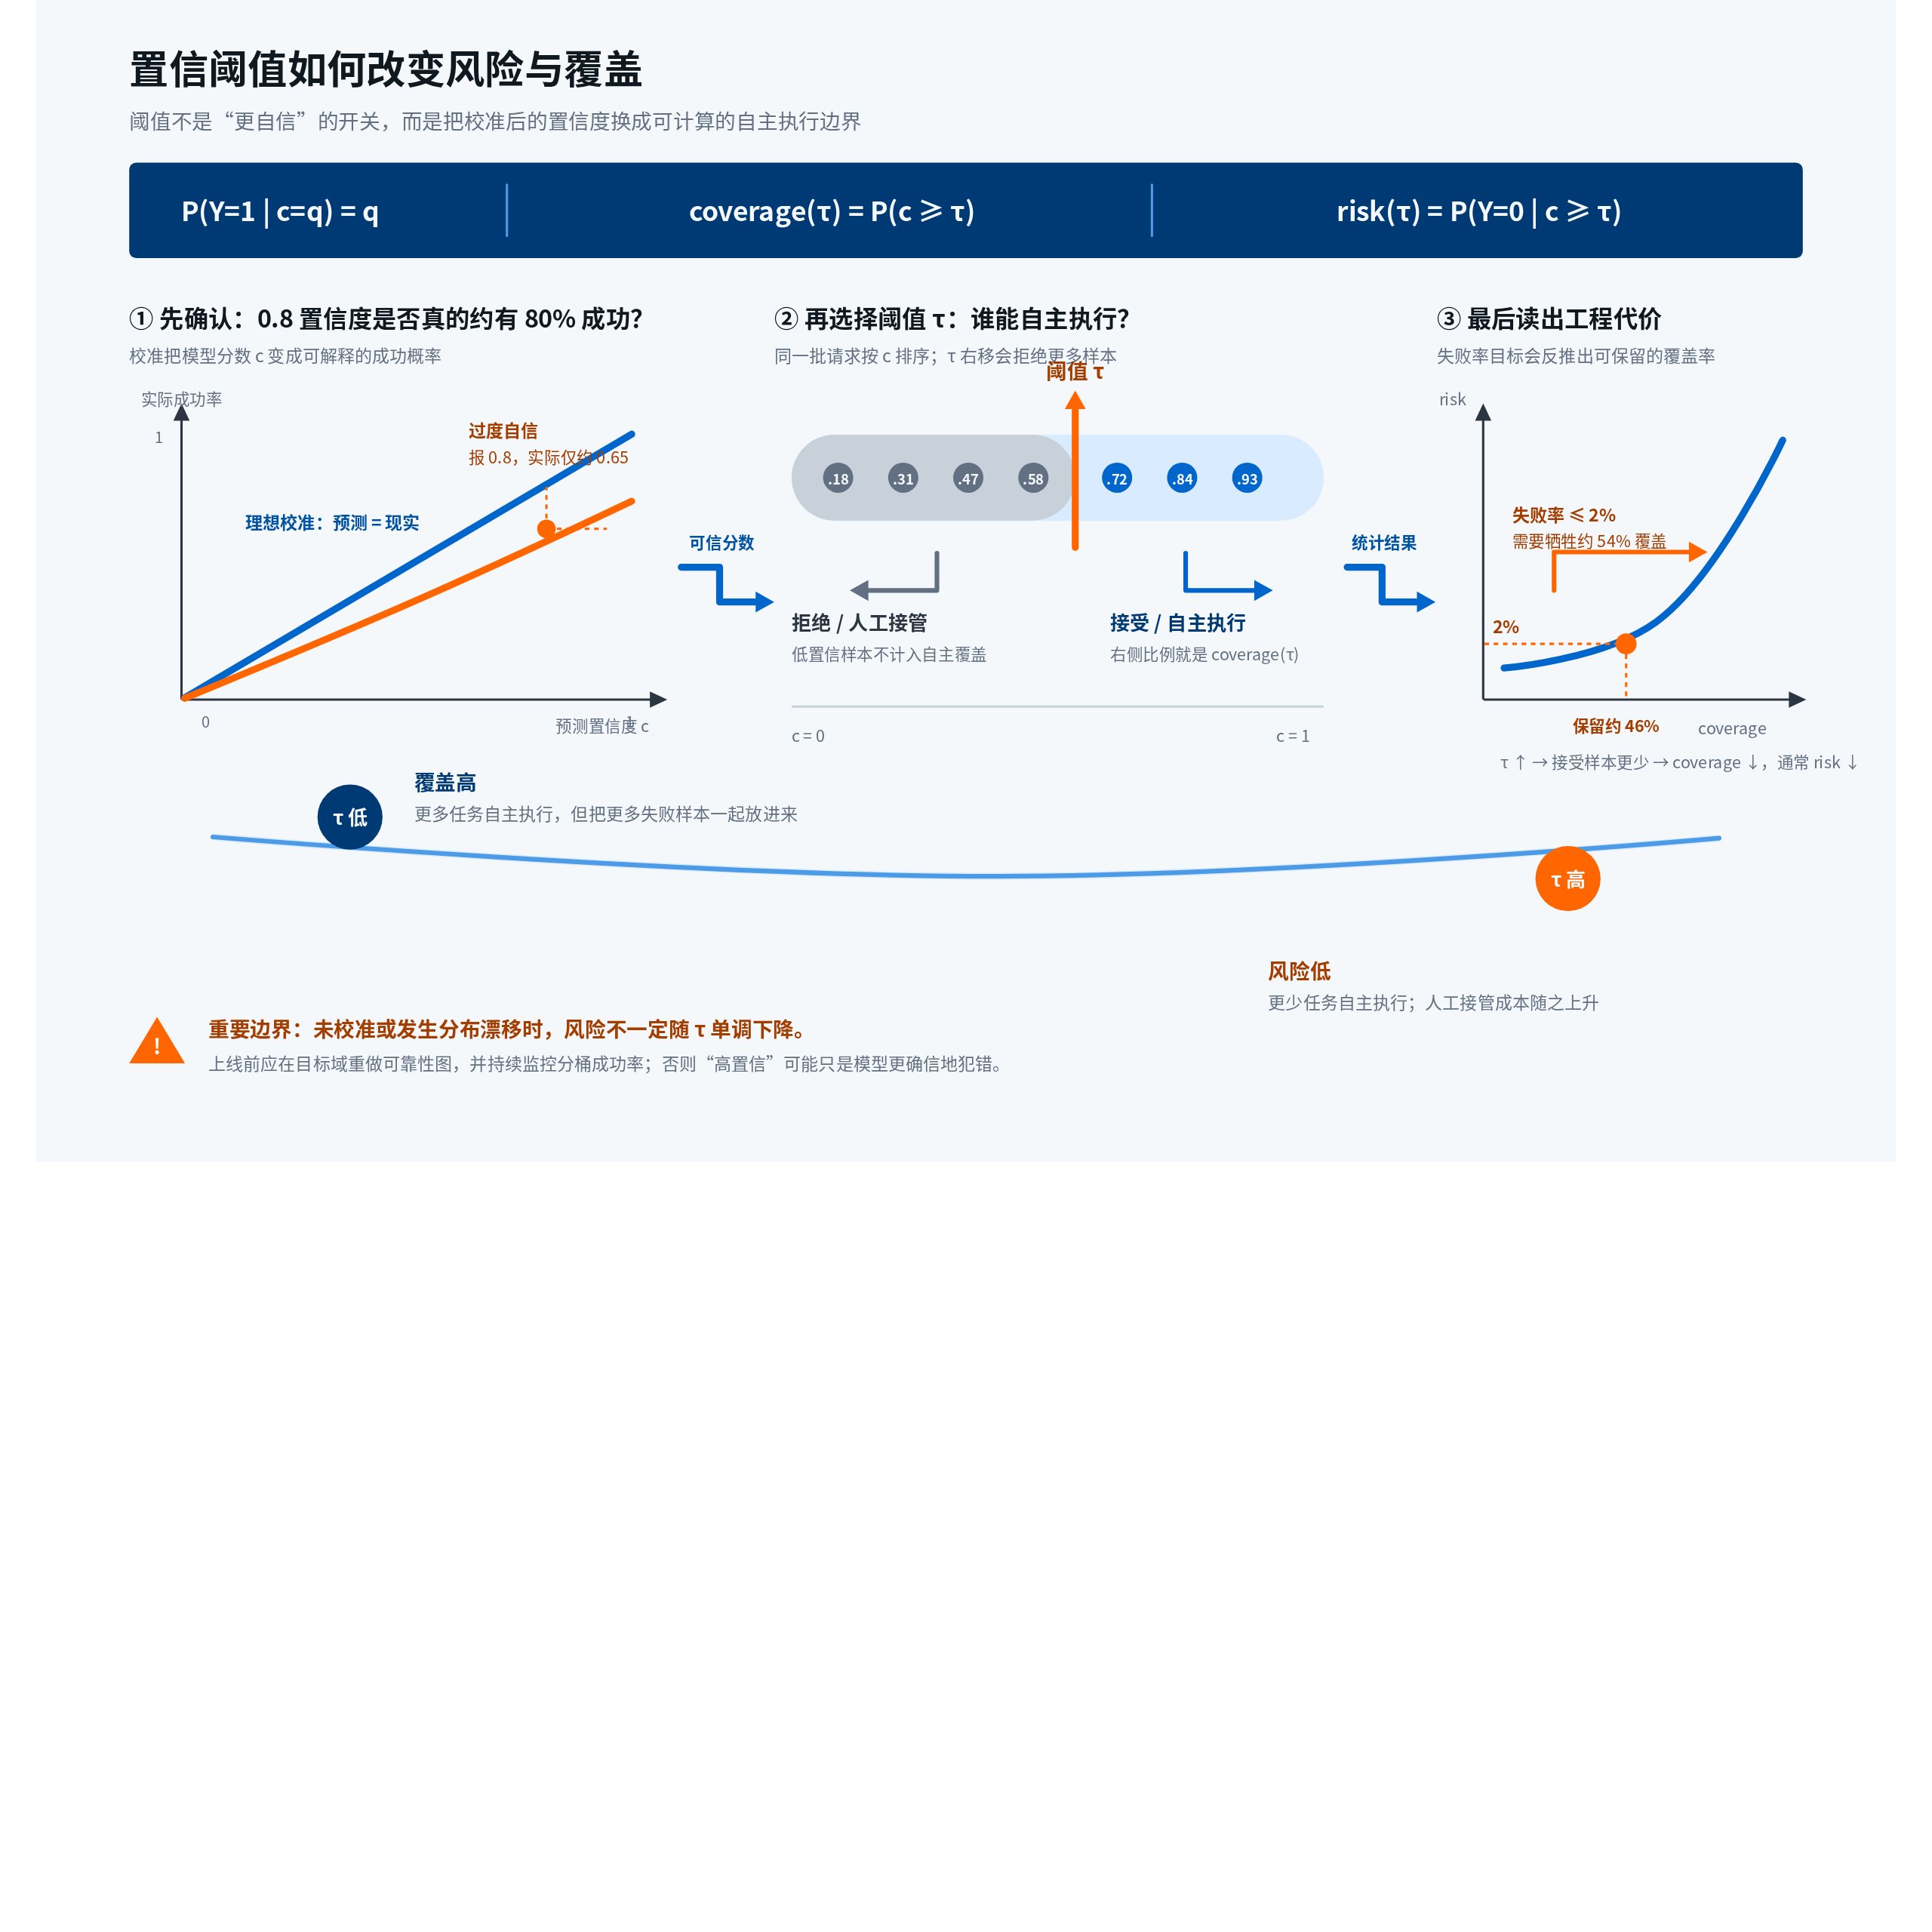
若模型预测成功概率为 ,理想校准满足:
读法: 若模型校准良好,那么所有预测置信度为 q 的试验中,长期应有约 q 比例真正成功。
推导: 校准把概率预测解释为条件频率:在相同预测值的样本集合中,结果均值应等于该预测值。有限数据只能通过分桶、平滑或校准模型近似检验这一条件。
Expected Calibration Error:
读法: ECE 对每个置信度桶的真实成功率与平均置信度差取绝对值,再按桶样本比例加权求和。
推导: 理想校准要求连续置信度上的条件频率相等,但有限样本无法逐点估计,于是用 B 个桶做分段近似。桶内准确率估计结果频率,桶内平均置信度估计预测概率,二者差异的经验加权即为 ECE。
ECE 依赖分箱,不能单独使用。还应看 Brier score、负对数似然和可靠性图。
Brier score。 校准之外还要同时惩罚概率预测与真实结果的平方误差:
读法: Brier score 是每次预测成功概率与实际零一结果之差平方的平均。
推导: 把概率预测看作对 Bernoulli 结果均值的估计,平方误差在真实条件概率处取得最小期望,因此它是 proper scoring rule。它同时反映校准和区分能力,值越小越好,但仍应按任务难度和安全子群分层报告。
9. 选择性预测与风险覆盖
机器人可以在低置信度时请求人工、重新感知或采用保守策略。设接受阈值为 :
读法: 阈值 tau 下的覆盖率,是模型置信度达到阈值、允许自主执行的试验比例。
推导: 选择性系统只接受置信度不低于 tau 的样本,因此接受事件是 c 大于等于 tau。其概率可用测试集中满足条件的样本比例估计;tau 越高,通常覆盖率越低。
读法: 阈值 tau 下的选择性风险,是所有被允许自主执行的试验中失败所占的条件概率。
推导: 先用 c 大于等于 tau 筛选接受集合,再在该集合内计算失败均值。随着阈值升高,系统放弃更多低置信试验,风险通常下降,但若置信度未校准或存在分布漂移,风险不一定单调改善。
画风险-覆盖曲线能回答:“为了把失败率降到 2%,需要放弃多少自主执行比例?”这比单一 AUROC 更接近部署决策。
公式可视化|置信阈值如何改变风险与覆盖
10. 最小可视化实验
生成数据。 构造 20 个难度不同的任务,每个任务包含共享的随机难度、日期批次效应和若干配对初始条件。策略 A、B 在同一条件上随机交错执行,并生成一个与真实成功概率存在系统偏差的置信度。
| 实验模块 | 比较 | 预期学到什么 |
|---|---|---|
| 样本量 | 8/10、16/20、80/100 和 160/200 的 Wilson 区间 | 相同比例不代表相同证据强度 |
| 相关性 | naive pooling、按 episode bootstrap、按任务或日期 cluster bootstrap | 把相关试验当独立样本会怎样低估区间 |
| 配对设计 | 独立比例差、配对 bootstrap、McNemar 精确检验 | 共享难度被消除后统计功效怎样变化 |
| 分层效应 | 微平均、宏平均、分层 logistic 和每任务效应 | 总体提升是否来自简单任务权重变化 |
| 校准 | 可靠性图、ECE、Brier score 和温度缩放前后 | 高准确是否伴随过度自信 |
| 选择偏差 | 从 20 个 checkpoint 反复选最佳,再用锁定测试集复核 | 排行榜和测试集反复查看怎样产生乐观偏差 |
最小输出。 成功率与区间图、每任务配对差值图、cluster bootstrap 分布、可靠性图、风险覆盖曲线和“开发集最佳值 versus 锁定测试值”散点图。
发布判据。 预注册主要效应、分层单位和安全指标;报告全部训练重复与测试条件。只有主要效应的区间、困难任务切片和安全风险同时支持改进,才声称“整体变好”。
11. 常见失效模式
| 失效模式 | 为什么错 | 决定性检查 | 修复 |
|---|---|---|---|
| 把帧数当样本量 | 同一 episode 内帧高度相关,不能重复计算成功证据 | 按帧与按 episode bootstrap 比较区间 | 以 episode 或更高层 cluster 为重采样单位 |
| 微平均掩盖困难任务 | 简单任务试验更多会主导总成功率 | 同时画宏平均、每任务效应和任务权重 | 预先固定采样配额并分层报告 |
| 反复查看测试集调参 | 选择过程把测试噪声拟合成模型提升 | 比较开发集最佳与一次性锁定测试结果 | 限制测试访问并记录全部实验 |
| 实验后修改成功定义 | 结果决定标签规则,产生研究者自由度 | 审计原始视频、标注版本和修改时间 | 预注册成功标准,盲法复核争议样本 |
| 只报告均值 | 异质任务和高代价失败被平均掉 | 查看置信区间、分位数、失败类型和安全成本 | 报告效应分布与尾部风险 |
| 语言置信度直接当成功概率 | token 概率未针对物理任务结果校准 | 可靠性图、Brier、ECE 与分布漂移切片 | 用真实机器人结果校准并设置风险覆盖门禁 |
12. 本课练习
- 计算 16/20 与 160/200 的 Wilson 区间并比较。
- 设计一个按对象、初始位姿和日期分层的配对实验。
- 解释 cluster bootstrap 为什么应按 episode 或日期重采样。
- 构造一个总体成功率提升但所有困难任务退化的 Simpson 悖论例子。
- 为“低置信度请求人工”定义风险覆盖发布门限。
与其他路线的关系
所有路线最终都必须接受本课的统计审问。路线 A 的泛化、B 的预测收益、C 的经验改进、D 的长时任务、E 的跨本体迁移和 F 的接触安全都不能只用一个平均成功率证明。
13. 统计方法与评测论文证据矩阵
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| Wilson 1927|Binomial Interval | Wilson 通过 score test 推导二项比例区间,避免简单 Wald 区间在小样本和边界附近的异常行为。 | 作者从推断方程而非对经验比例直接加减标准误构造区间。 | 机器人试验次数通常很少,默认报告 Wilson 或更稳健区间,而不是只报百分比。 |
| Efron 1979|Bootstrap | Bootstrap 用经验分布重采样近似统计量的抽样分布。 | 作者把未知总体分布替换为观测数据的经验分布,借助重复重采样估计不确定性。 | 重采样单位必须匹配独立性结构;按帧 bootstrap 会制造虚假样本量。 |
| Bates et al.|lme4 | 该工作系统描述线性与广义线性混合效应模型的软件实现和估计方法。 | 作者用固定效应表达总体关系,用随机效应表达组间异质性和组内相关。 | 跨任务、日期和机器人试验应显式建模 cluster,而不是把所有 episode 平铺。 |
| Benjamini & Hochberg 1995|FDR | 该方法在多重假设检验中控制期望错误发现比例。 | 作者区分逐项错误率与发现集合中的错误比例,提供比 Bonferroni 更有功效的程序。 | checkpoint、任务切片和指标很多时,先锁定主要分析;FDR 不能修复反复查看最终测试集。 |
| Guo et al. 2017|Calibration | 该工作显示现代神经网络可能准确但过度自信,并比较 temperature scaling 等校准方法。 | 作者把分类正确性与概率可靠性分开评估。 | 机器人门控所需的是物理任务成功概率校准,不是语言模型 token 概率。 |
| Geifman & El-Yaniv|Selective Classification | 该路线研究模型允许拒绝部分样本时,风险与覆盖率之间的权衡。 | 作者用置信排序选择更可靠的子集,并分析覆盖减少如何降低错误风险。 | Physical AI 应报告风险覆盖曲线,把“请求人工多少次”与“自主失败多少次”放在同一图上。 |
14. 交叉阅读
与 G0 连读。 G0 定义证据链,G1 给出成功率、相关性、校准和选择性部署的统计工具。
与所有算法路线连读。 所谓泛化、价值提升、规划收益和控制鲁棒性,都必须说明独立试验单位、效应量、区间和失败分布。
与 G3 连读。 风险覆盖曲线和校准决定线上何时自动执行、何时降级或请求人工。