

飞书原文 · 源修订 12
💡
机制课: 机器人需要记住当前任务进度、过去失败、对象位置和新演示。本课比较上下文记忆、外部记忆、参数适配与快速权重,并重点解释测试时训练和 WAM-TTT。
学习目标
完成本课后,应能区分工作记忆、情节记忆、外部检索和快速权重;写出测试时适配的 inner/outer loop;分析记忆污染、遗忘和人机对齐;设计错误演示、无关演示和安全门控实验。
1. 为什么需要记忆
单帧观测无法回答:
- 哪个物体已经处理。
- 夹爪是否刚刚滑动。
- 之前尝试过哪种抓法。
- 用户刚刚演示了什么。
- 当前环境与训练环境有什么新差异。
记忆把历史信息压缩成当前决策条件。
2. 四种记忆
| 记忆 | 载体 | 更新 | 风险 |
|---|---|---|---|
| 上下文记忆 | 历史 token / hidden state | 每步 | 上下文长度和遗忘 |
| 外部记忆 | 轨迹库、对象图、数据库 | 显式写入 | 检索错误和过期 |
| 参数记忆 | 模型权重 | 训练时 | 更新慢 |
| 快速权重 | 可塑参数或 adapter | 测试时 | 污染与灾难遗忘 |
3. 上下文记忆
策略:
读法: 当前动作从以最近 L 步观测、过去 L 步动作和任务目标为条件的策略分布中采样。
推导: 部分可观测环境中,单帧无法确定被遮挡对象、任务阶段和动作后果;把有限历史窗口加入条件能恢复部分状态信息,但窗口之外的关键事件会被截断,计算量也随 L 增长。
有限窗口简单,但早期任务状态可能被截断。RNN/Transformer hidden state 可以持续汇总,却难验证具体记住了什么。
4. 外部情节记忆
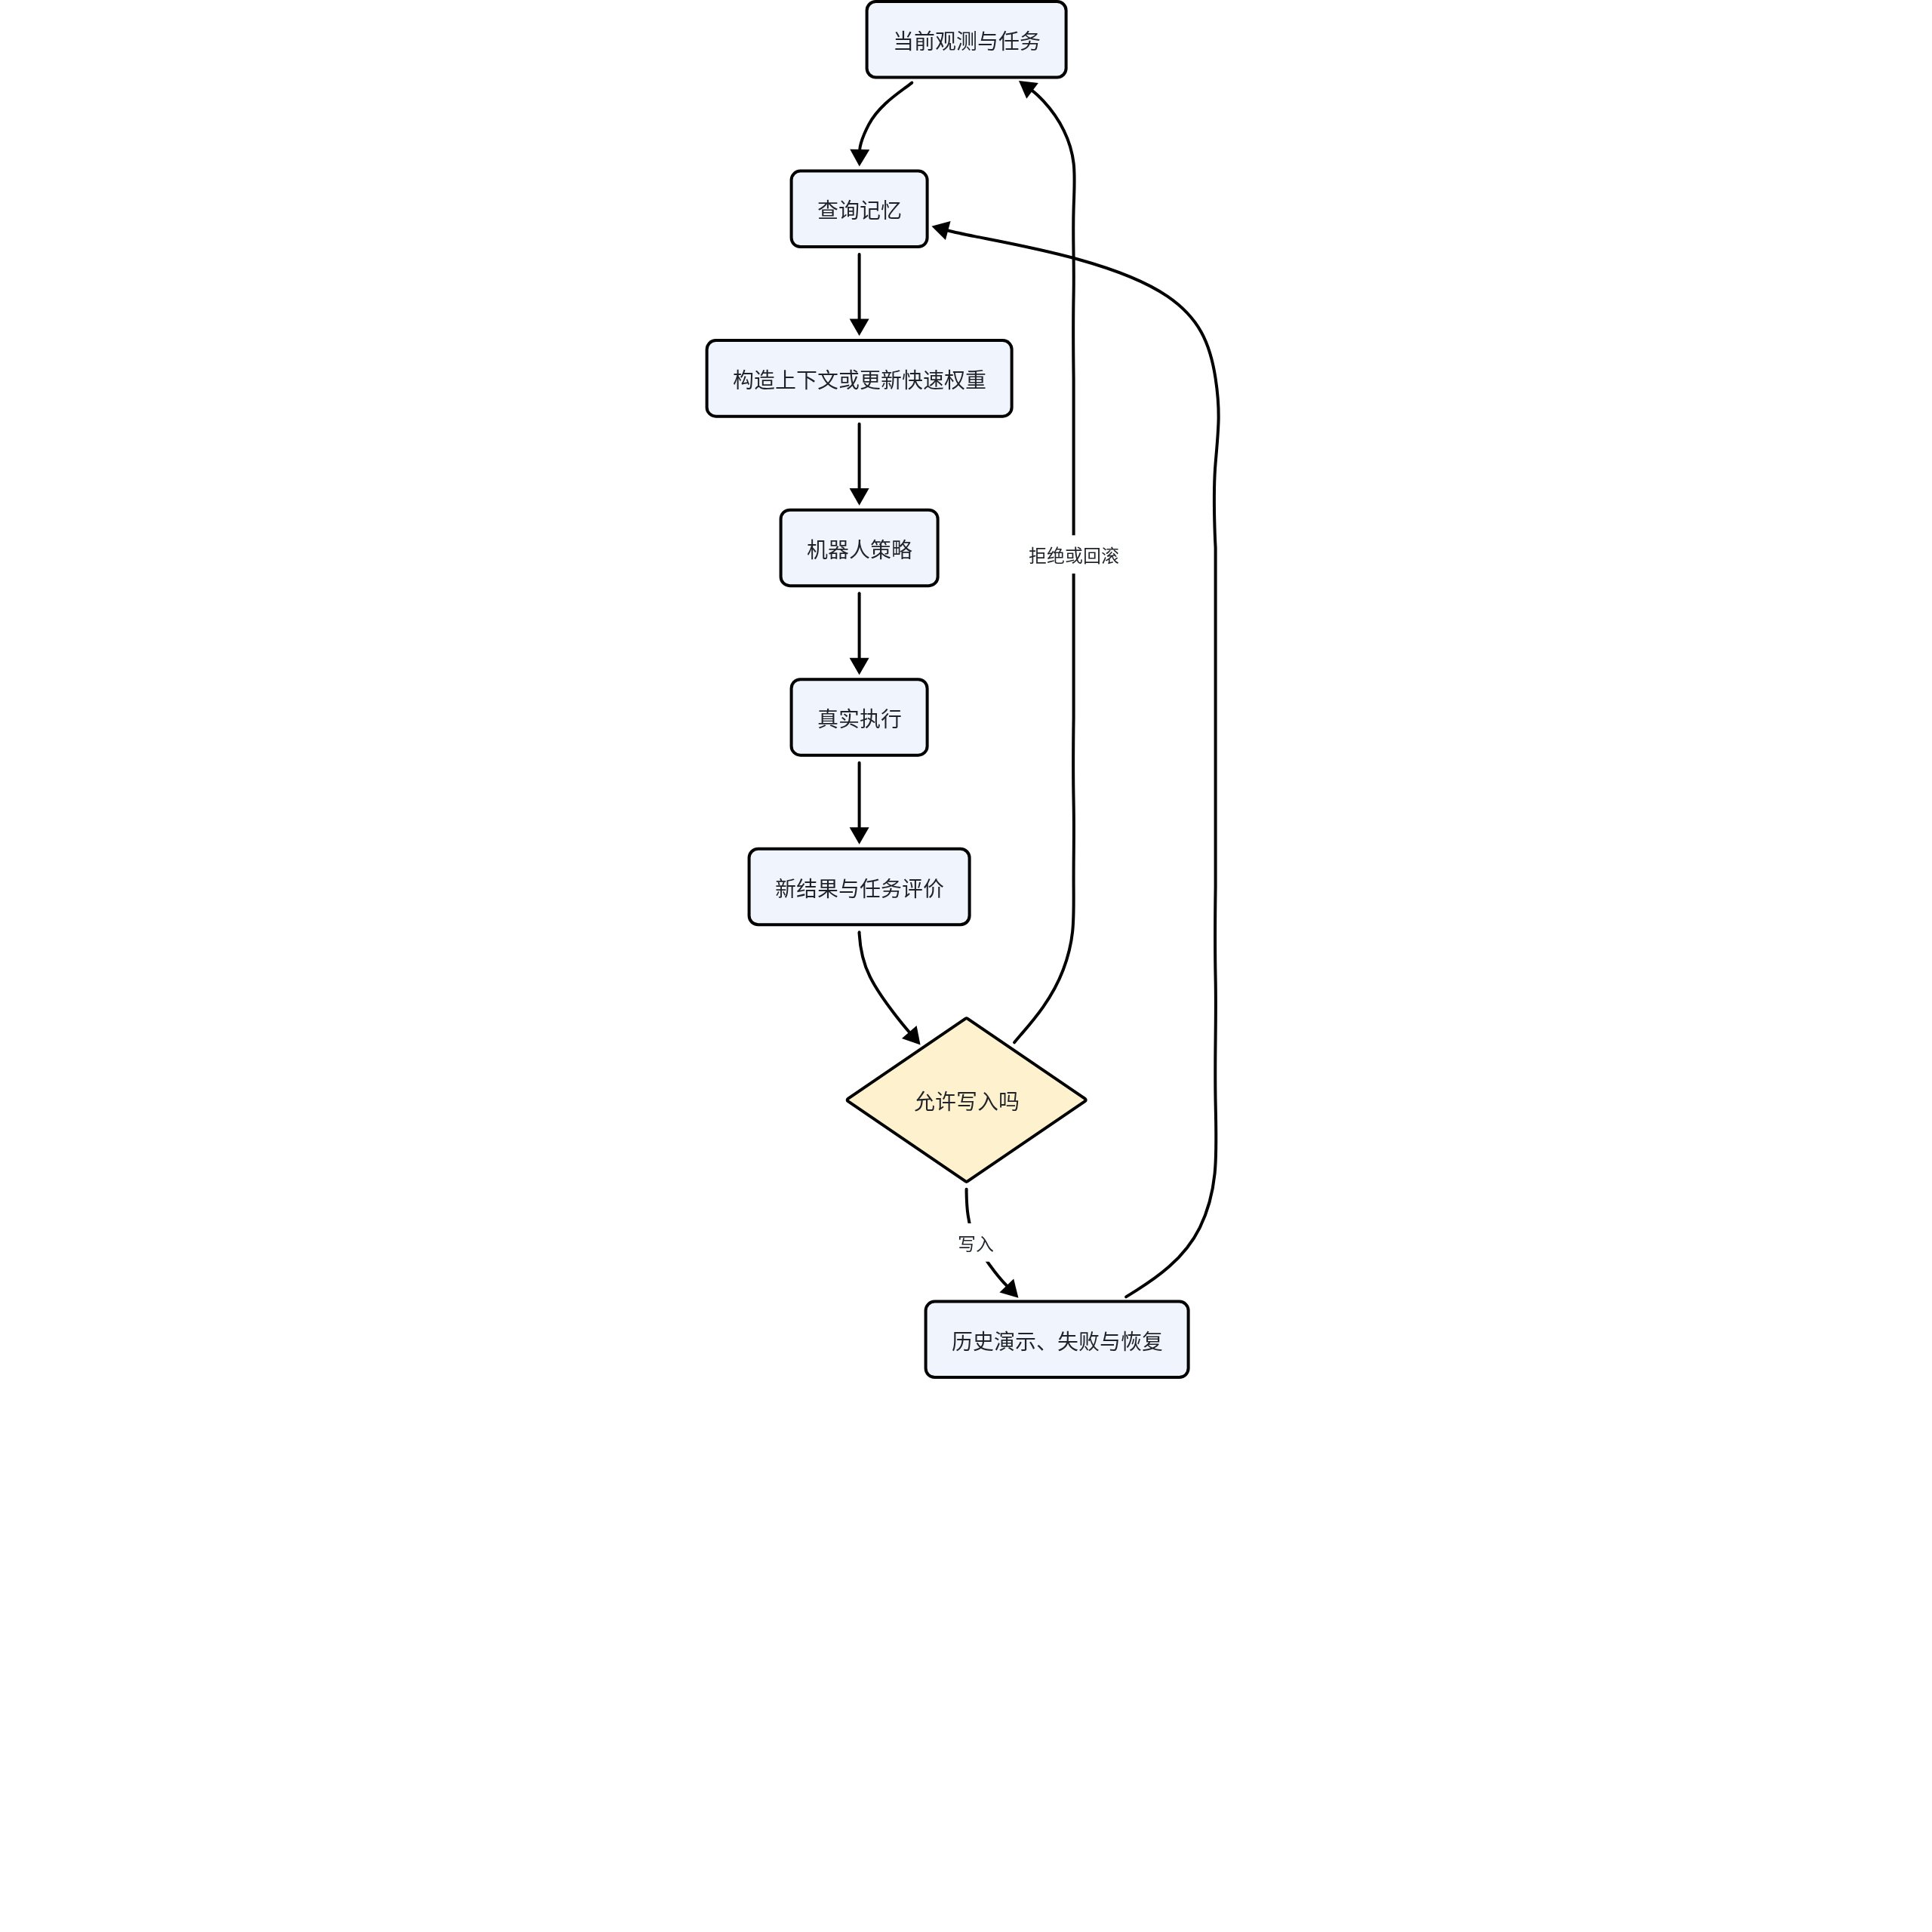
检索与当前状态相似的经验:
读法: 在记忆库 M 中,选择键 k_i 与当前观测和任务编码最相似的记忆项 m_i。
推导: 编码器 E 把当前情境映射为查询向量,检索器用相似度排序历史经验。若键只编码外观,相似图像可能对应不同质量、接触或任务阶段,因此可靠检索还应包含对象身份、本体状态和失败原因。
将检索到的轨迹、失败原因或恢复技能作为策略条件。相似视觉不一定意味着相同物理状态,需要对象、任务阶段和本体 metadata。
5. 测试时适应的双层优化
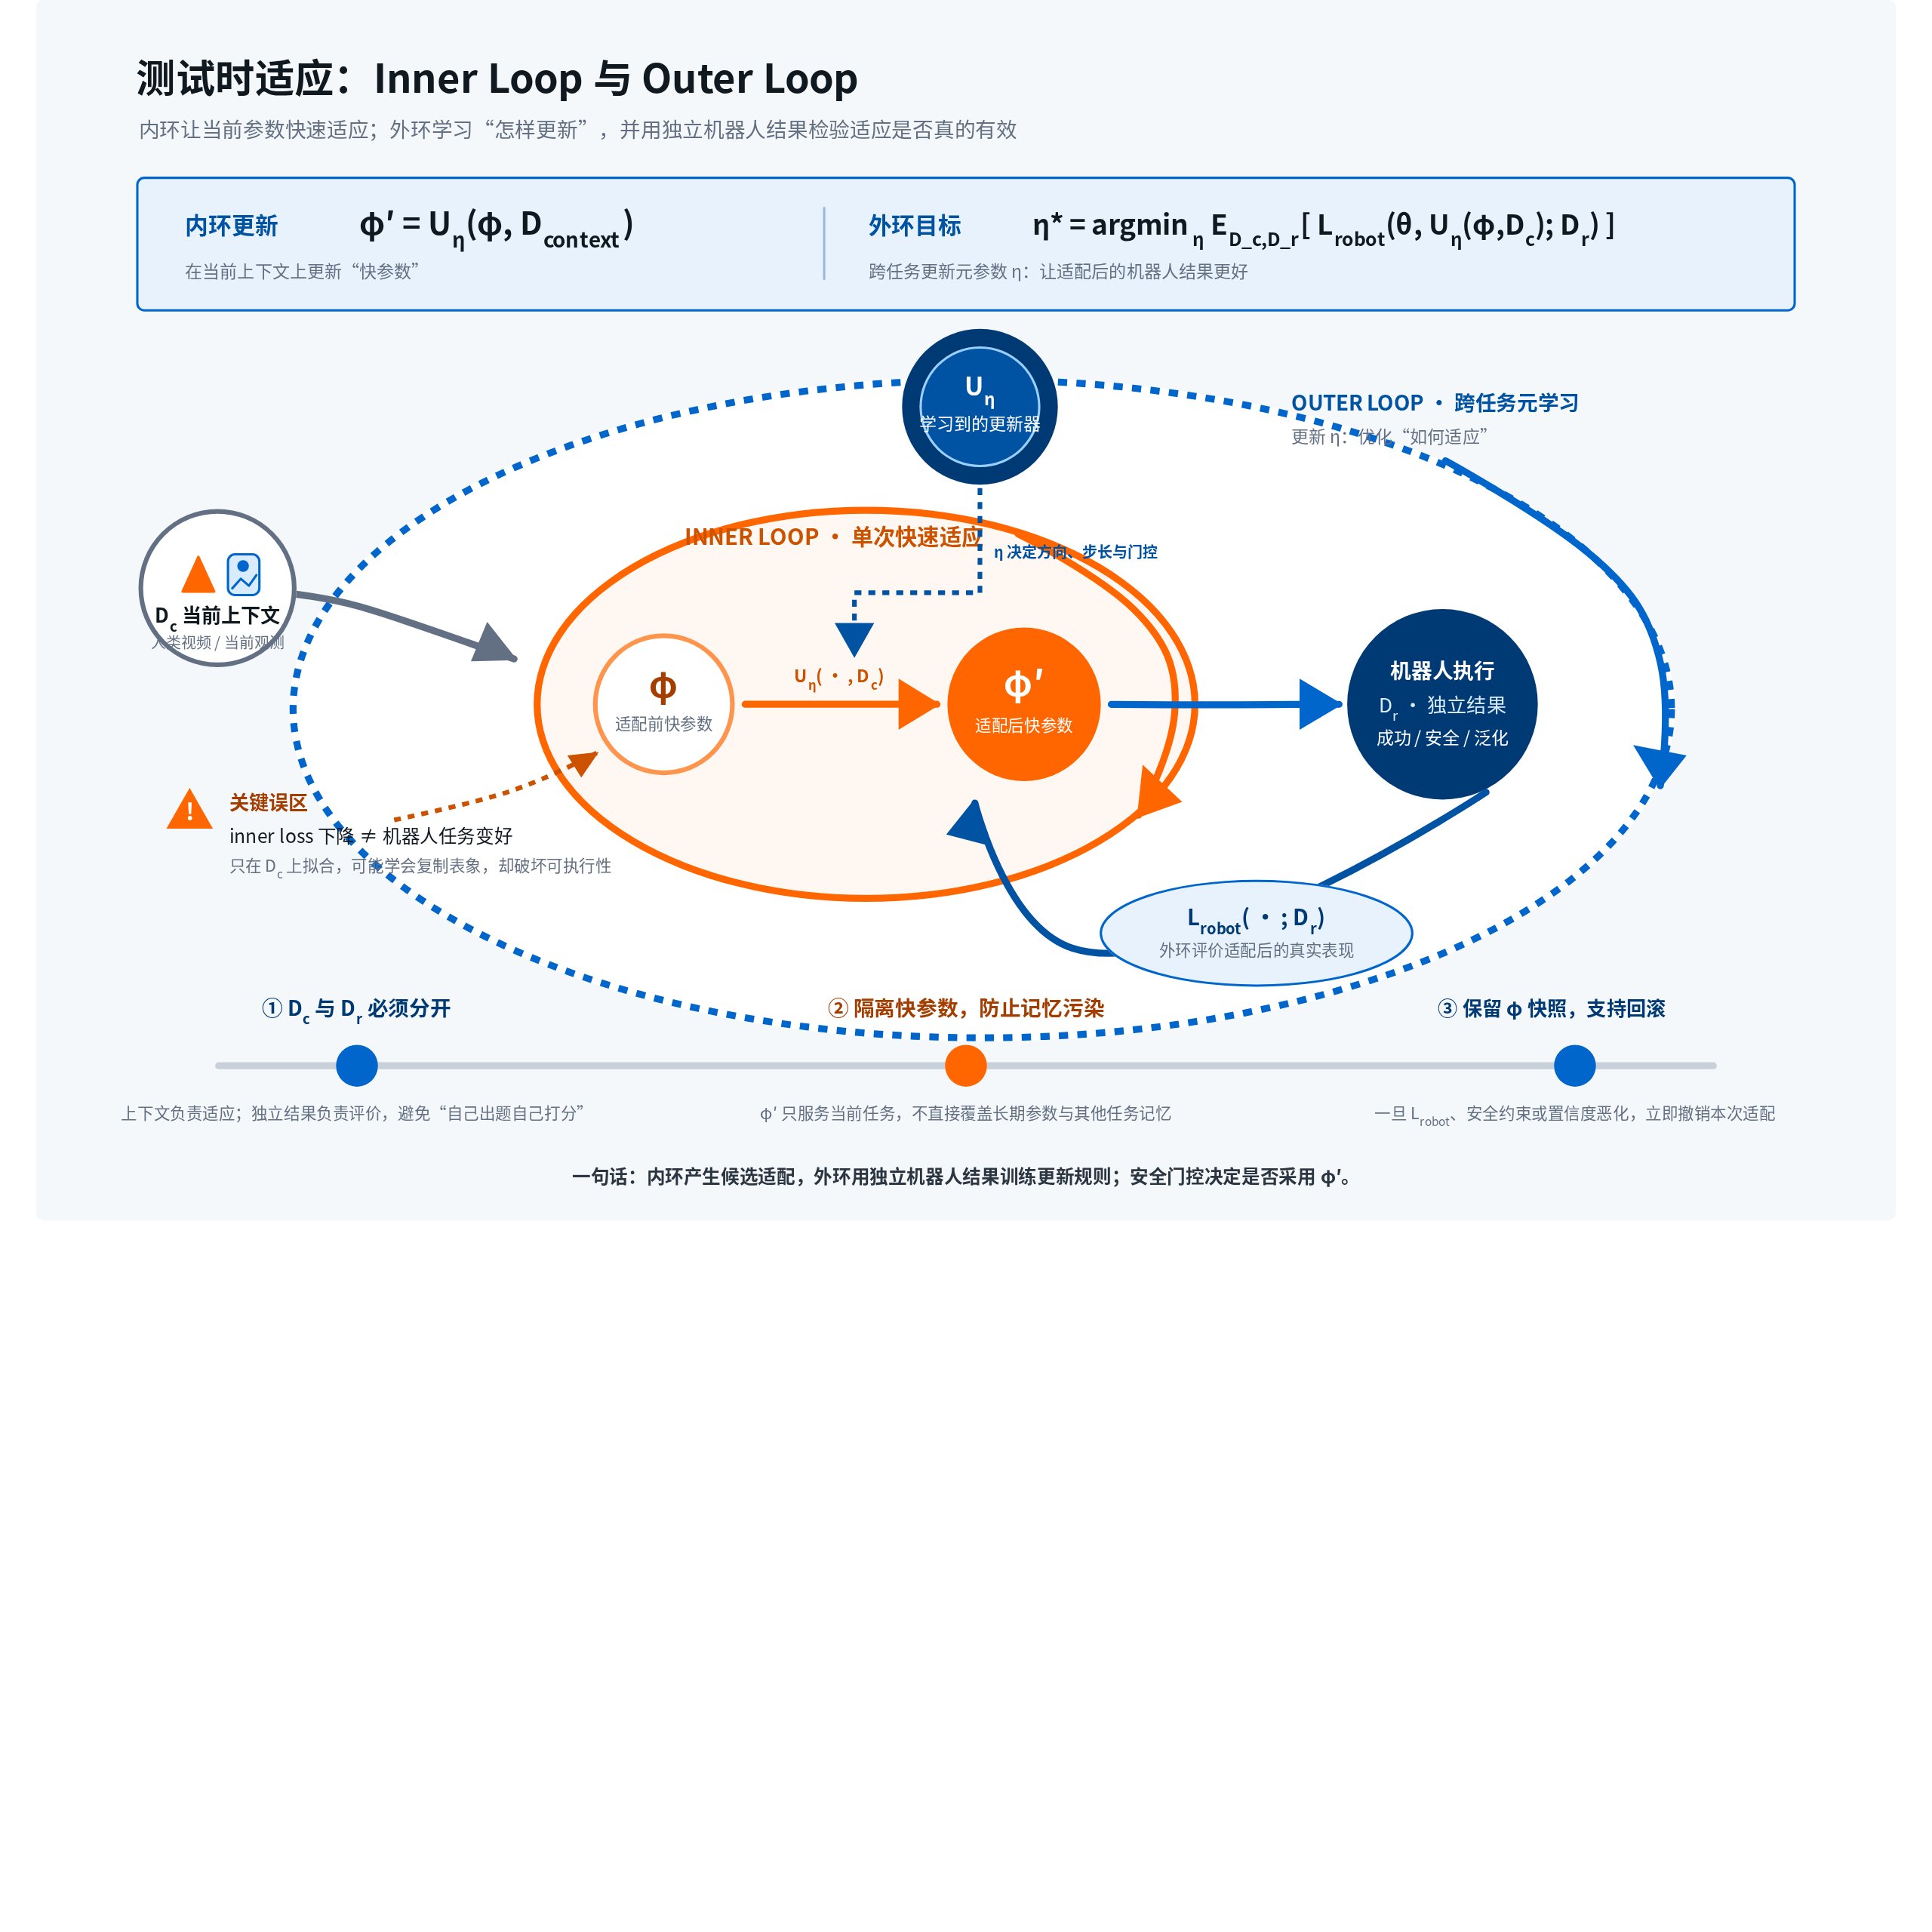
Inner loop 用当前环境数据更新快速参数:
读法: 更新规则 U_eta 根据原始快速参数 phi 和当前上下文数据,产生适配后的参数 phi prime。
推导: inner loop 把演示、无标签视频或交互反馈压缩进快速权重。U_eta 可以是一到数步梯度下降、学习出的优化器或显式记忆写入器;关键是更新范围受控且可以回滚。
Outer loop 用机器人任务结果优化更新规则:
读法: 选择更新规则 eta,使它读取上下文数据 D_c 后,在独立机器人任务数据 D_r 上的期望损失最小。
推导: outer loop 必须在与写入信号分开的机器人结果上评价更新,否则更新器可能只会降低辅助损失而伤害控制。对任务和环境分布取期望,才训练出可跨情境泛化的“怎样更新”。
关键不是 inner loss 本身下降,而是更新后机器人任务表现提高。
公式可视化|测试时适应的 Inner Loop 与 Outer Loop
6. 测试时训练信号
| 信号 | 优点 | 风险 |
|---|---|---|
| 视频预测 | 无需动作标签 | 外观适配不等于行为适配 |
| 对比一致性 | 利用多视角/时间 | 任务相关性弱 |
| 伪动作 | 连接状态变化 | 伪标签偏差 |
| 人类演示 | 任务和环境特定 | 跨本体对齐 |
| 机器人失败 | 匹配部署分布 | 安全和错误写入 |
7. WAM-TTT 的机制
World-Action Model 学习视觉、潜在动作与机器人动作的共享结构。测试时人类视频写入 fast-weight memory,机器人策略读取更新后的记忆。
Meta-training 需要:
- Inner loop 只看人类侧信号。
- Outer loop 用机器人动作任务判断更新是否有用。
- 训练环境包含人类与机器人任务对应关系。
如果人机任务同步或阶段对齐不成立,记忆可能写入错误行为。
8. 记忆门控
不是所有经验都应该写入。门控概率:
读法: 门控模型根据候选经验 x、不确定性 u 和当前任务 g,估计允许写入记忆的概率。
推导: 把写入决定表示为二元变量 w,可用正确性、任务相关性、安全性和回滚收益监督门控。高不确定性不必然意味着拒绝写入,但应触发更保守的验证或沙盒适配。
应考虑:
- 演示是否与当前任务相关。
- 模型是否理解对象和阶段。
- 更新后小规模验证是否改善。
- 是否可以回滚。
- 安全边界是否保持。
9. 记忆污染与遗忘
| 问题 | 表现 | 应对 |
|---|---|---|
| 错误演示 | 快速适配后能力下降 | 置信门控、对照验证 |
| 无关演示 | 记忆干扰当前任务 | 任务路由与隔离 |
| 连续用户 | 偏好互相覆盖 | 用户级 adapter |
| 长期任务 | 早期信息遗忘 | 外部状态图 |
| 写入过多 | 推理成本和检索噪声 | 压缩、淘汰和摘要 |
10. 记忆的评测
- 无演示基线。
- 正确演示。
- 无关演示。
- 错误演示。
- 任务阶段打乱。
- 对象相同但任务不同。
- 适配后旧任务保持。
- 更新回滚与安全门控。
11. 最小实验:写入记忆是否真正改善机器人任务
选择一个包含新对象位置、新背景或新操作者习惯的操作任务,把同一基础策略复制为无适配、上下文窗口、外部检索、快速权重四种系统。固定基础模型、机器人训练数据、测试时可见帧数、更新步数和总推理时间。
- 分别提供正确演示、无关演示、错误演示、阶段打乱演示和同对象不同任务演示。
- 把用于写入的上下文与用于评价的机器人 rollout 严格分开。
- 比较全参数更新、受限层更新、显式 memory token 和只读检索。
- 适配后重新评测旧任务,测量遗忘和跨任务污染。
- 对高风险动作启用影子评估、门控拒绝和一键回滚。
最低报告项: 适配前后成功率、达到同等提升所需上下文量、错误演示造成的性能下降、无关演示敏感度、旧任务保持率、门控精确率与召回率、回滚后恢复程度、更新计算与延迟。
12. 本课练习
- 为长时整理任务设计工作记忆字段。
- 比较上下文 memory 和参数适配。
- 写出 inner/outer loop 的数据边界。
- 设计错误演示的安全实验。
- 说明检索相似度为何需要任务和本体条件。
- 解释 WAM-TTT 的人机同步假设。
13. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 记忆截断 | 长时任务早期信息离开上下文窗口后被忘记 | 显式任务状态、摘要记忆或外部事件日志 |
| 检索错配 | 找到外观相似但物理状态或任务阶段不同的经验 | 把对象、任务、本体与失败原因加入键,并报告检索命中质量 |
| 错误演示污染 | 一次错误或对抗演示持续降低后续控制 | 写入门控、独立验证集、影子更新和可回滚快照 |
| 辅助目标投机 | 测试时 loss 下降,但机器人成功率下降 | outer loop 使用独立机器人结果,报告 loss 与任务收益相关性 |
| 灾难性遗忘 | 适应新环境后旧任务或安全技能退化 | 限制更新参数、正则化、旧任务回放和保持率评测 |
| 人机阶段错位 | 人类视频展示的阶段与机器人当前需求不同 | 事件对齐、任务谓词校验和阶段打乱对照 |
| 更新漂移 | 连续多个 episode 写入后参数逐渐离开安全区域 | 更新范数、版本链、周期重置和最大适配预算 |
| 隐私与数据残留 | 外部记忆保存不应长期保留的人类或环境信息 | 最小化存储、过期策略、访问控制和可删除性 |
14. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| MAML | 通过跨任务元优化,学习能用少量梯度步骤快速适配的初始化 | 训练目标可以直接塑造模型的可适应性 | 它提供双层优化地基,但真实机器人还需处理更新安全、数据相关性和在线计算成本 |
| Test-Time Training | 在测试样本上用自监督辅助任务更新模型,再执行主任务预测 | 测试分布自身可以提供适应信号 | 辅助 loss 下降不是控制改善的充分证据;机器人必须在独立 rollout 上验证收益与安全 |
| RoboCat | 统一多机器人与多任务数据,并展示用新任务演示进行后续训练和数据自增强 | 通用机器人智能体可以通过新经验持续扩展能力 | 这更接近离线或阶段式自改进,不应与单 episode 内的测试时快速权重混为一谈 |
| WAM-TTT | 用人类侧上下文在测试时写入快速记忆,并以机器人动作任务监督更新机制 | 人类演示可以帮助机器人适应当前环境或任务 | 关键审计项是人机任务对应、严格留出环境、错误演示对照、更新稳定性和回滚能力 |