

飞书原文 · 源修订 8
💡
机制课: VLA 可以直接从图像输出动作,但物理闭环仍隐含地需要位置、姿态、速度、遮挡和不确定性。本课建立从 Bayes 滤波、SE(3)、深度与点云到对象中心状态和可供性的统一语言。
学习目标
完成本课后,应能区分观测与状态;推导 Bayes filter 的预测和校正;读懂位姿、坐标变换、深度反投影和对象中心表示;解释端到端策略为何仍需要状态可辨识性;设计遮挡、相机变化与标定误差实验。
1. 图像不是状态
机器人真正需要的状态可能包括自身位姿、关节速度、对象六自由度姿态、接触模式和障碍物,而相机只提供这些变量经过投影、遮挡和噪声后的观测:
读法: 当前观测由当前真实状态通过观测模型随机产生。
推导: 同一状态在不同光照和相机下产生不同图像;同一图像也可能对应不同深度和遮挡关系,因此必须用概率分布表达不确定性。
2. Bayes filter:历史怎样变成信念状态
预测步骤:
读法: 把上一步所有可能状态,按照动作条件动力学传播到当前时刻并加总,得到看新观测之前的预测信念。
推导: 由全概率公式,对未知的上一状态积分;动力学给出从上一状态到当前状态的条件概率。
校正步骤:
读法: 用当前观测在每个候选状态下出现的可能性,重新加权预测信念,再通过归一化常数使概率和为一。
推导: 直接应用 Bayes 公式;先验是预测信念,似然是观测模型,后验是校正后的信念状态。
3. Kalman filter 是线性高斯特例
读法: 状态按线性动力学和控制输入演化,并叠加过程噪声;观测是状态的线性投影,并叠加观测噪声。
推导: 把非线性动力学在工作点附近近似为矩阵 A 和 B,把传感器近似为矩阵 C;若过程噪声和观测噪声都是高斯,线性变换与高斯乘积仍为高斯,所以信念只需维护均值和协方差。
在线性高斯假设下,信念始终是高斯分布,只需维护均值和协方差。非线性系统使用 EKF/UKF,强多峰和离散接触模式常需要粒子滤波或学习滤波器。
4. 三维位姿与 SE(3)
刚体位姿用齐次变换表示:
读法: 矩阵 T 由三维旋转 R 和三维平移 t 组成,用来把一个坐标系中的点转换到另一个坐标系。
推导: 三维点先旋转再平移。引入齐次坐标后,旋转和平移可以合并为一次矩阵乘法,连续坐标变换则通过矩阵相乘组合。
5. 从像素和深度反投影到三维
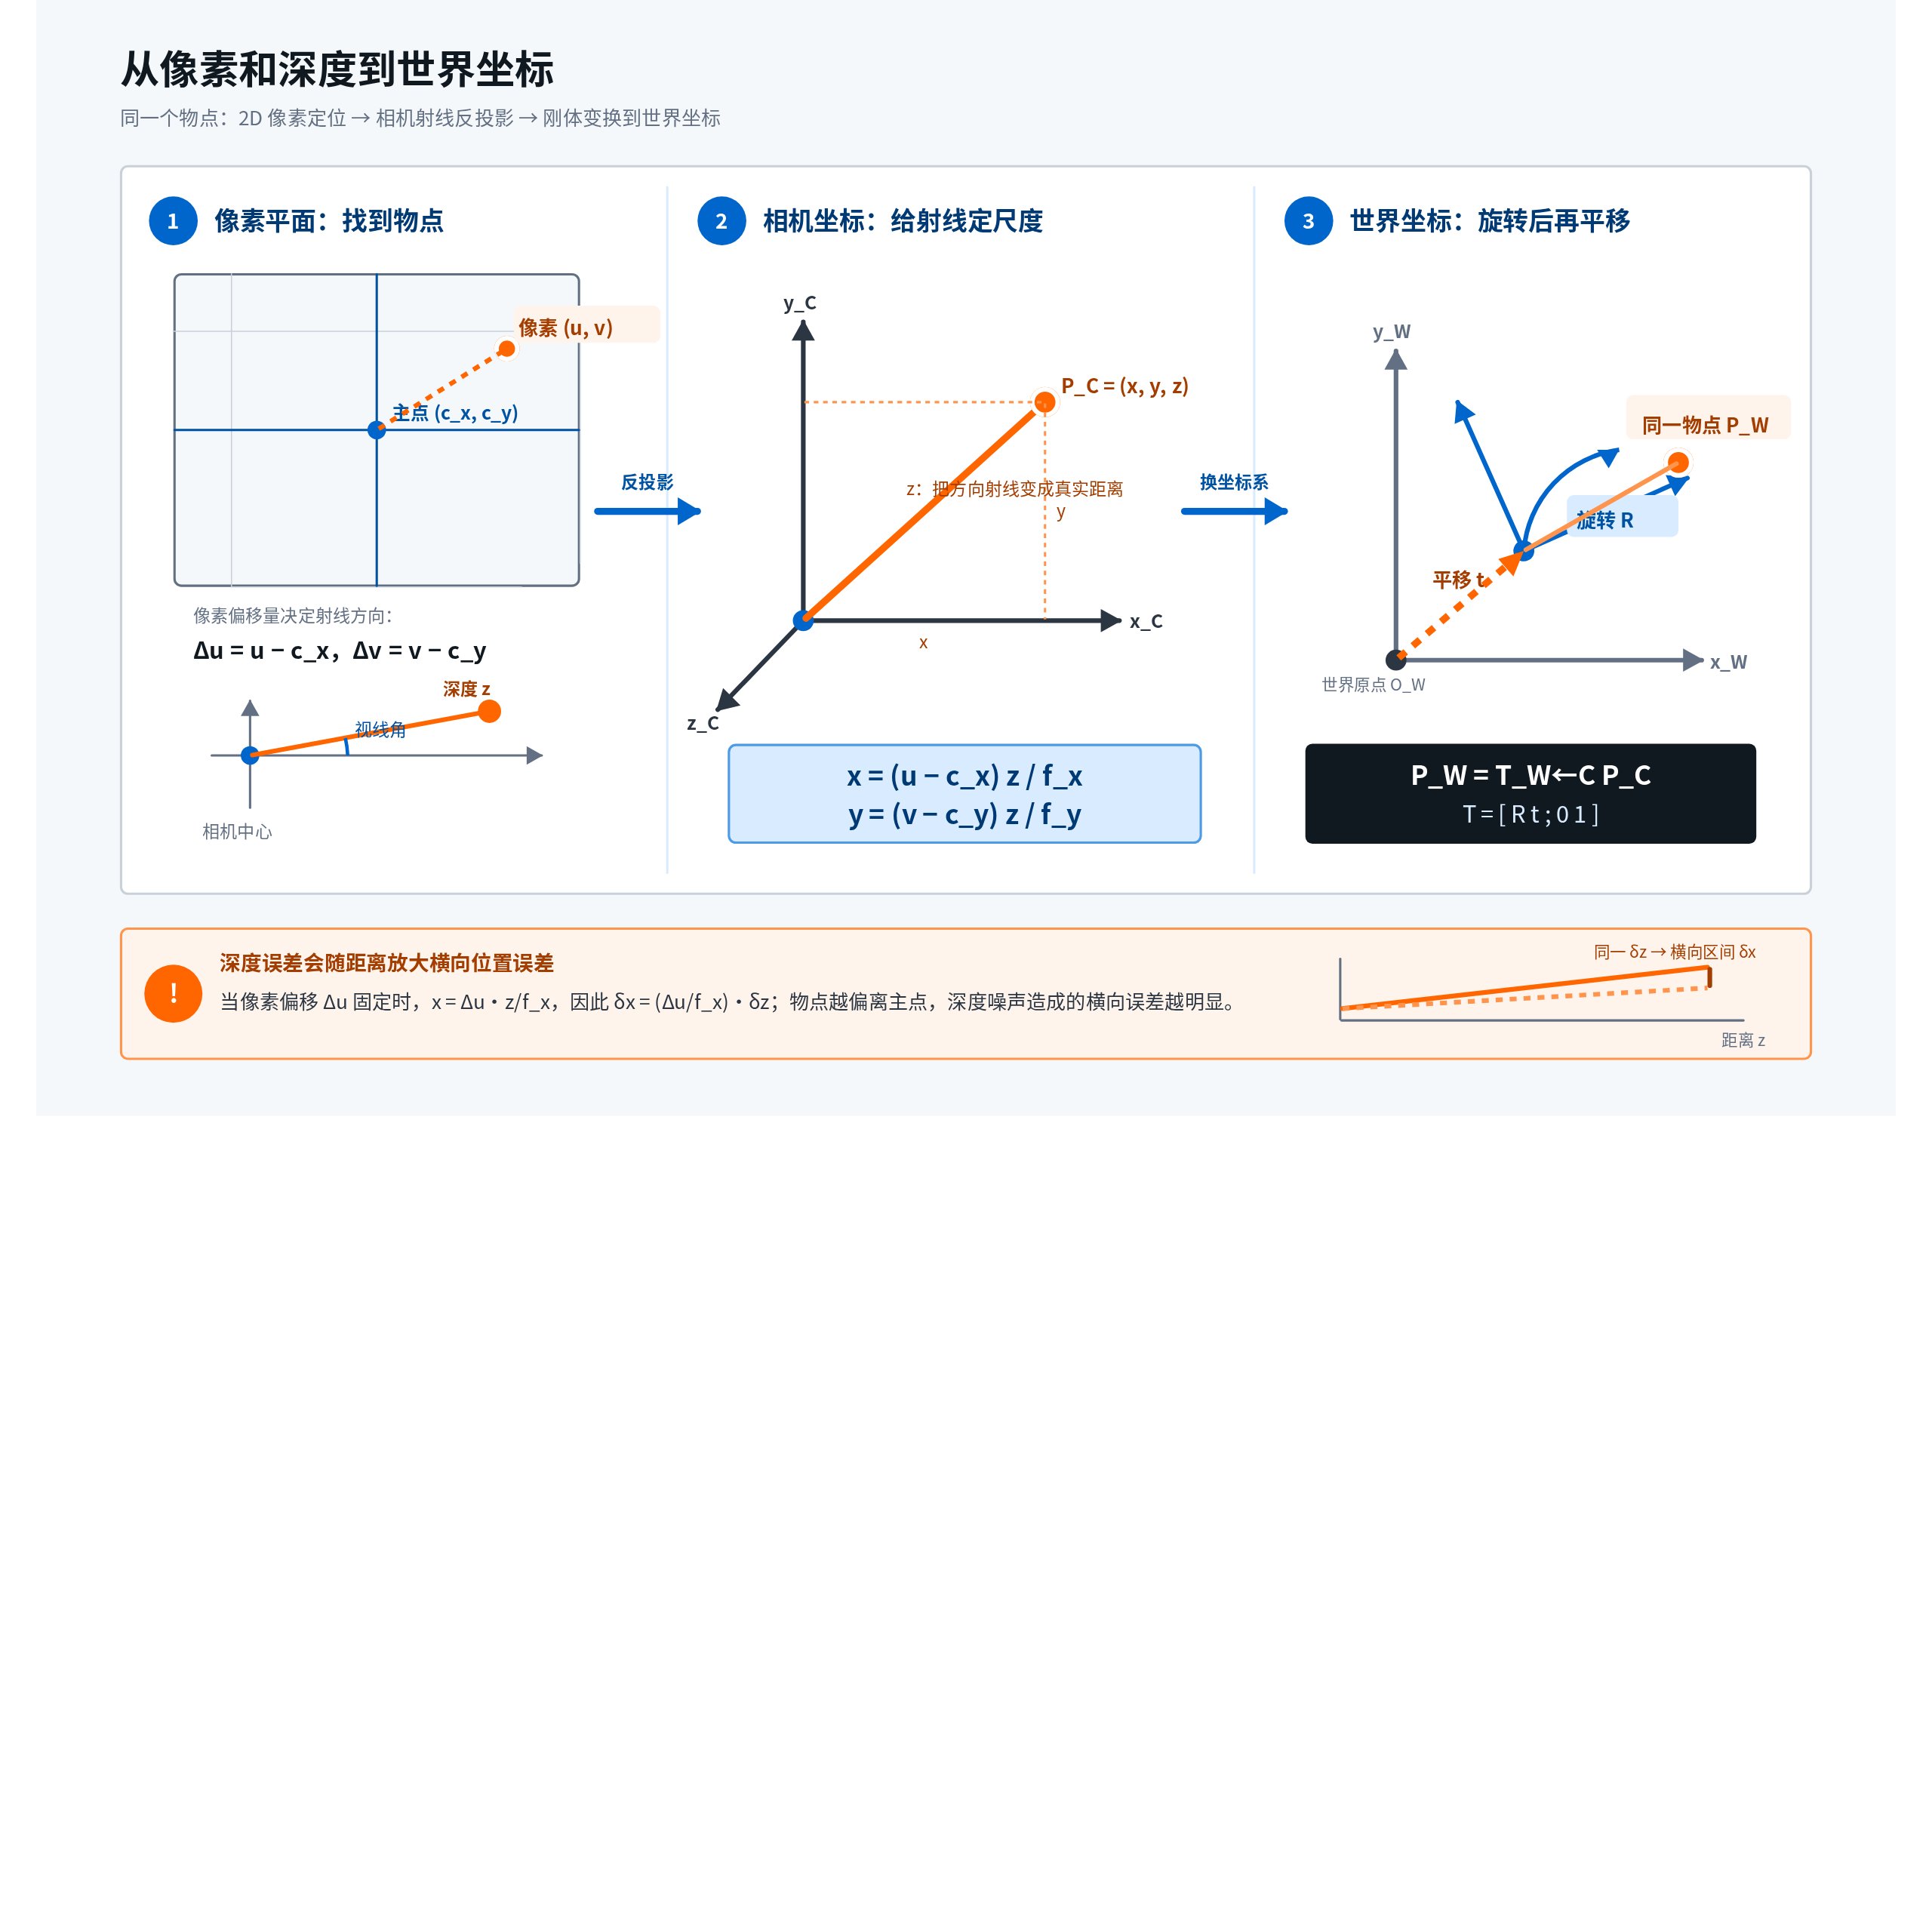
针孔相机中,像素 和深度 对应相机坐标:
读法: 像素相对主点的偏移,乘以深度,再除以焦距,得到相机坐标系中的横向和纵向位置。
推导: 由相似三角形,归一化成像坐标等于三维坐标除以深度;移项即可得到反投影公式。深度误差会随距离直接放大三维位置误差。
公式可视化|从像素和深度到世界坐标
6. 点云、体素、占据与神经场
| 表示 | 优势 | 限制 |
|---|---|---|
| 点云 | 保留直接三维测量 | 稀疏、无规则、遮挡明显 |
| 体素/占据网格 | 碰撞与空间查询方便 | 高分辨率成本大 |
| TSDF | 适合表面融合与重建 | 动态场景困难 |
| NeRF/Gaussian Splatting | 视图合成和连续场景表示 | 控制所需几何与实时更新需额外验证 |
| 对象中心状态 | 便于任务组合和关系推理 | 依赖稳定检测、跟踪和身份保持 |
7. 对象中心状态与可供性
策略不一定需要完整场景重建,可能只需任务相关状态:
读法: 潜在状态由 N 个对象组成;每个对象包含类别或语义、三维位姿、速度以及与任务相关的关系或属性。
推导: 把整幅场景拆成对象集合,可以让状态随对象数量扩展,并把抓取、遮挡和相互关系挂到具体实体上。类别 c、位姿 T、速度 v 和关系 r 是一个最小示例,真实系统还需为每项附带置信度或分布。
可供性不是对象的固定标签,而是对象、动作主体和任务共同决定的可行动关系。例如杯把“可抓”取决于夹爪大小、接近方向和当前遮挡。
8. 端到端 VLA 是否还需要状态估计
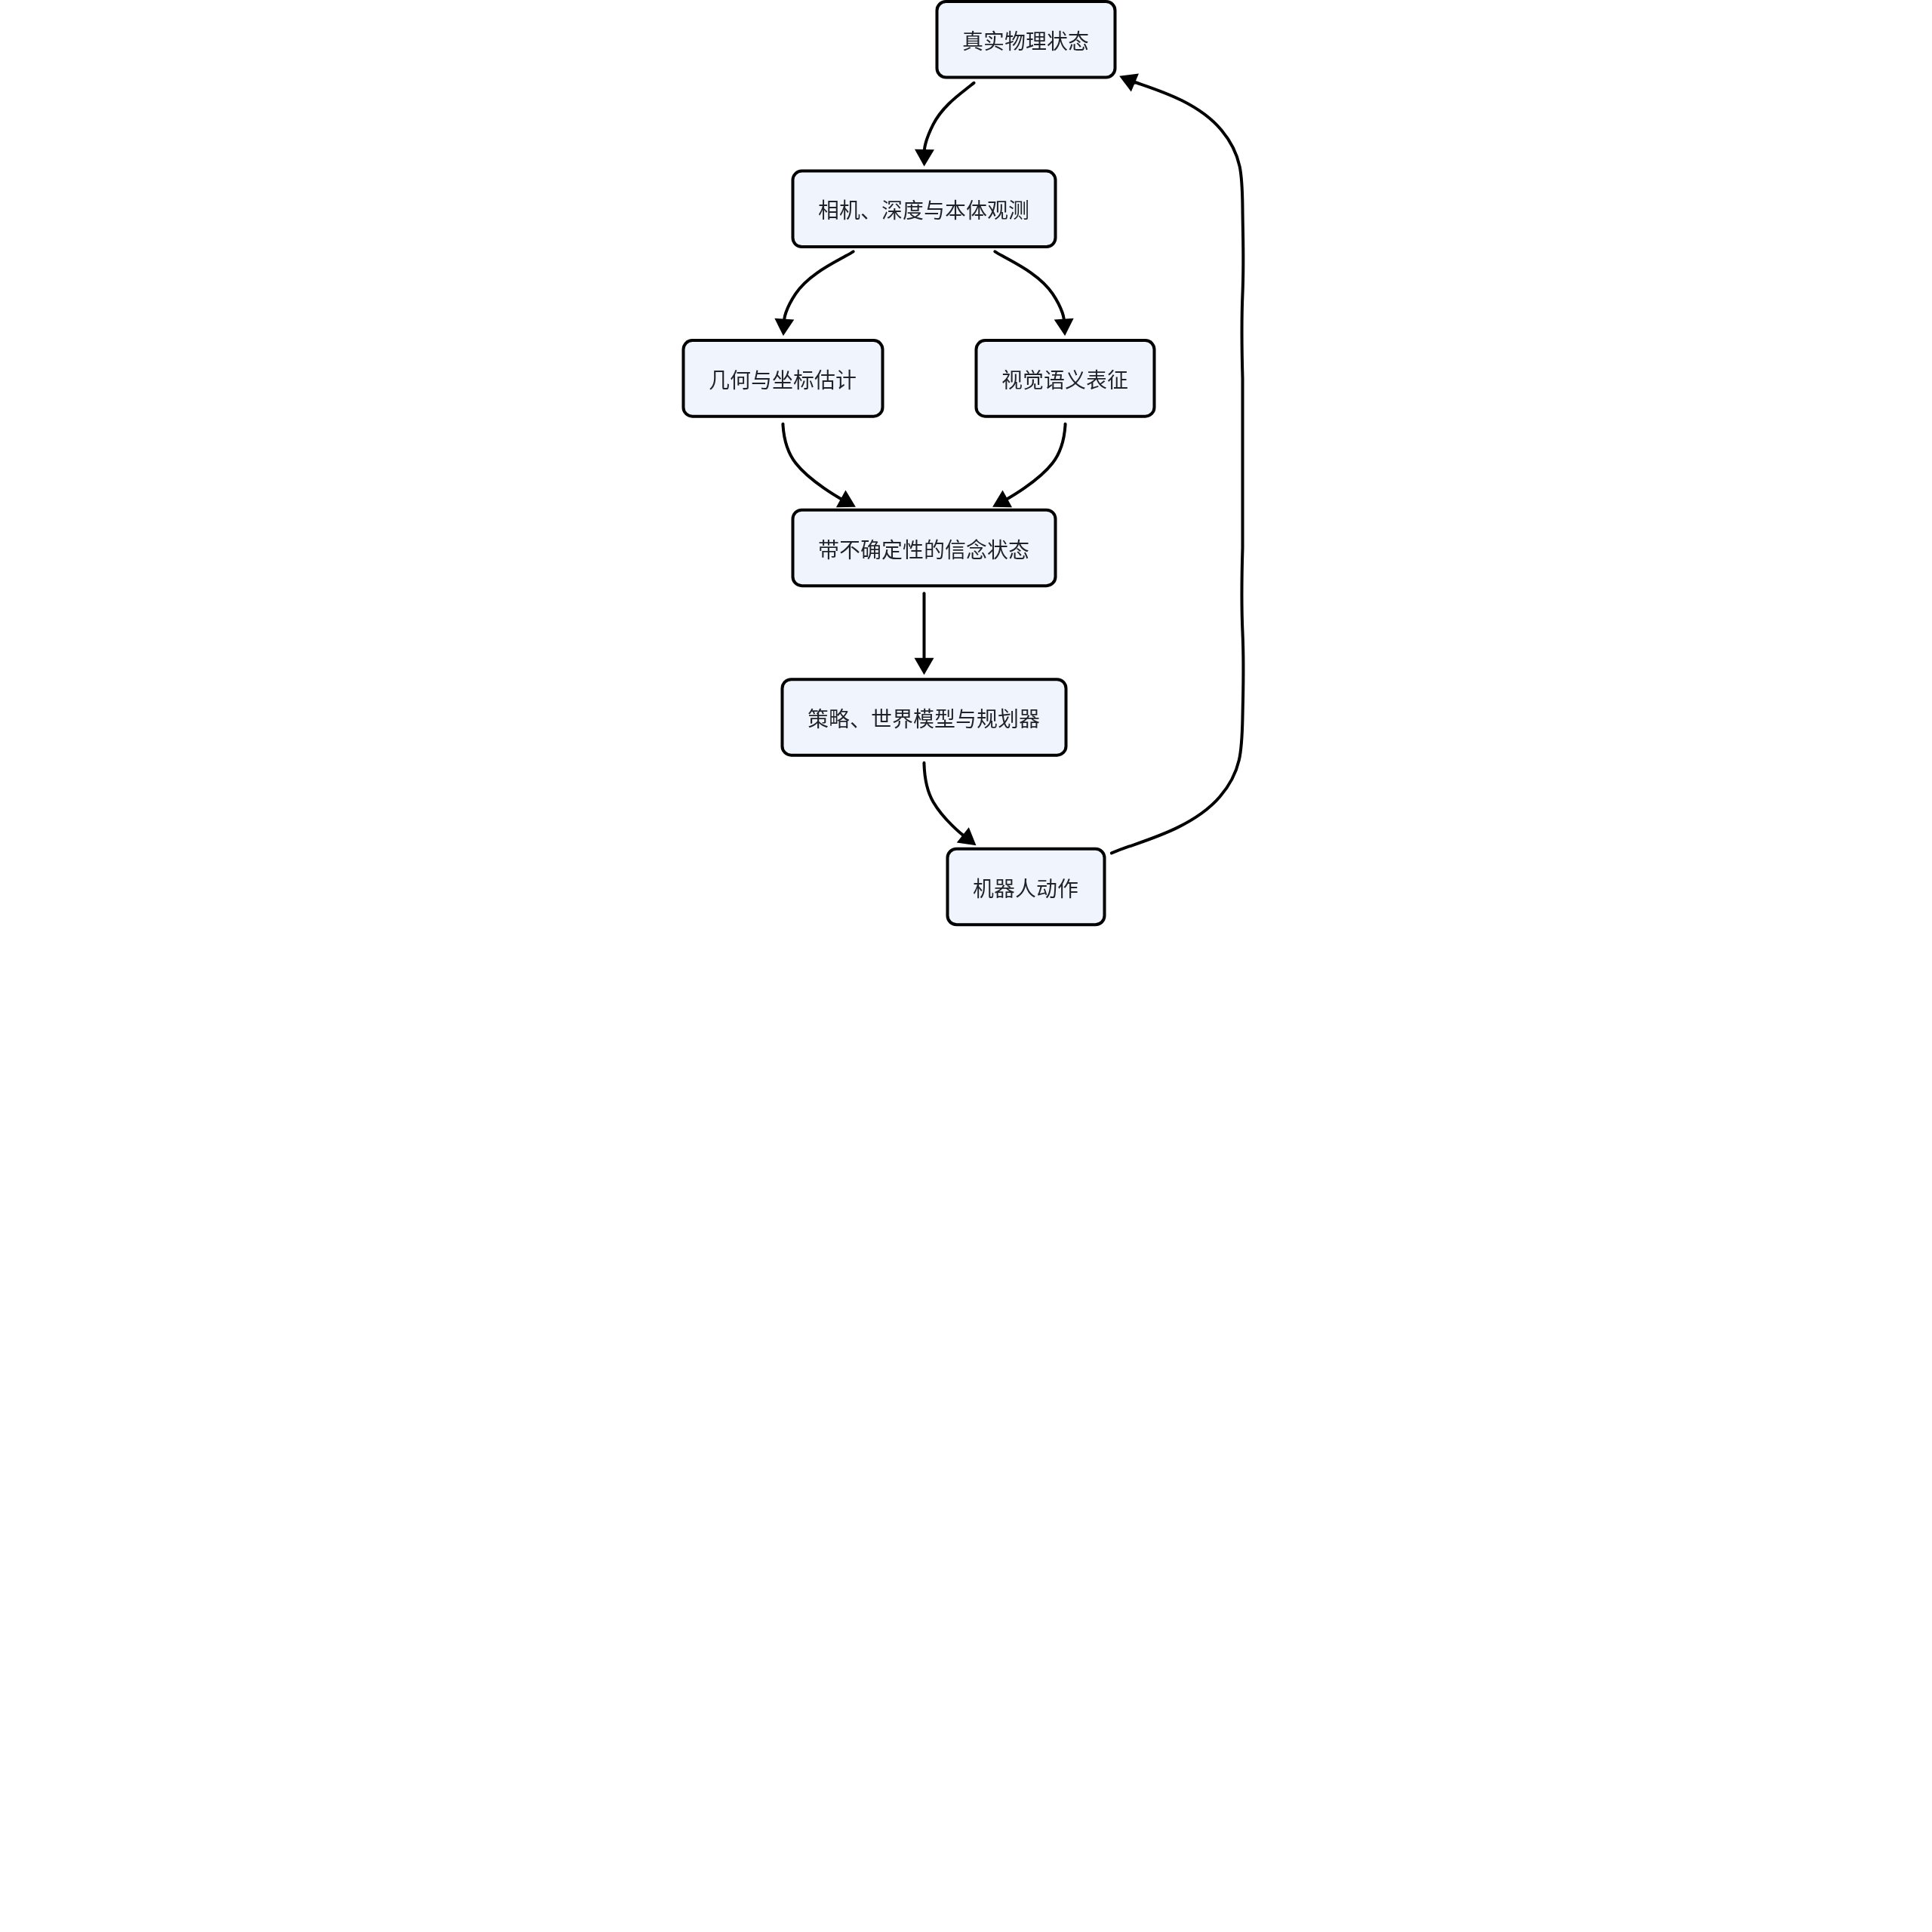
端到端模型可以把状态估计隐含在 Transformer 的上下文中,但不会消除可观测性问题。相机看不到背面、单帧无法确定速度、遮挡会让对象身份不确定。显式状态估计的价值是可调试、可校准和可用于安全约束;隐式状态的价值是减少人工建模并利用大规模数据。
9. 视觉表征与几何表征的边界
DINO、R3M、VC-1 等视觉表征可以提供语义和对应关系;深度、SLAM、DUSt3R 类几何模型提供相机与三维结构。语义相似不保证度量距离正确,几何准确也不保证知道对象用途。Physical AI 通常需要两者结合。
10. 最小实验
- 用一维位置与带噪观测实现 Bayes/Kalman filter,画先验、似然和后验。
- 让物体短时遮挡,比较单帧策略与带历史状态估计的策略。
- 对相机外参加入小扰动,测量末端定位和抓取成功率下降。
- 分别使用纯视觉 embedding、显式三维坐标和二者融合做目标抓取。
- 设计对象交换实验,验证模型是否保持对象身份而非只记像素位置。
11. 本课练习
- 从 Bayes 公式推导预测和校正两步。
- 解释单目单帧为什么不能唯一恢复绝对深度。
- 写出 base、camera、tool 与 object 四个坐标系的变换链。
- 构造语义正确但几何错误会导致抓取失败的例子。
- 为遮挡后的对象重现设计不确定性评测。
12. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 观测混同状态 | 遮挡后立即忘记对象,单帧歧义导致动作跳变 | 历史信念、对象持续性和不确定性 |
| 滤波器过度自信 | 均值看似稳定,真实状态已离开协方差范围 | 创新残差、覆盖率和噪声参数校准 |
| 线性化失效 | 大旋转、碰撞或离散接触切换时 EKF 发散 | UKF、粒子滤波、混合模式或重初始化 |
| 坐标系方向错误 | 视觉定位正确但机械臂向相反方向运动 | 明确每个 T 的 from/to 语义并做闭环标定测试 |
| 深度尺度或外参漂移 | 抓取点随距离和时间系统偏移 | 尺度真值、重投影误差和在线标定 |
| 对象身份交换 | 相似对象交叉后状态和任务历史互换 | 身份一致性、数据关联和多假设跟踪 |
| 语义正确、几何错误 | 识别到目标类别但位姿不足以抓取或插接 | 度量位姿、可达性与真实控制误差 |
| 几何准确、任务无关 | 重建场景很完整,却没有改善策略 | 任务相关对象状态、策略消融与计算预算 |
13. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| Kalman Filter | 在线性高斯系统中递推计算状态后验均值和协方差 | 历史动力学与当前观测可以按不确定性最优融合 | 它是理解 belief state 的地基,但接触、多峰遮挡和错误数据关联超出其基本假设 |
| ORB-SLAM3 | 统一视觉、视觉惯性和多地图 SLAM,估计相机轨迹与地图 | 几何跟踪和重定位可提供稳定空间参照 | 相机定位不等于对象状态与任务可供性,策略仍需对象级语义和动态关系 |
| DUSt3R | 从图像对直接回归点图并完成三维重建与对应 | 学习式几何可弱化传统相机标定和匹配流程 | 重建精度与尺度稳定性必须在机器人坐标和控制任务中复核 |
| DINOv2 / VC-1 | 通过大规模预训练获得可迁移的视觉语义表征 | 通用视觉特征可支持多种具身下游任务 | 语义对应不是度量几何;Physical AI 通常需要语义、几何和本体状态融合 |
14. 课程交叉阅读
建议把经典 SLAM/Kalman 教材与 R3M、VC-1、DINOv2、DUSt3R、对象中心学习和 3D 视觉语言模型对照阅读。课程关注的是这些方法向策略提供什么状态信息,而不是把感知 benchmark 本身当作机器人成功。