

飞书原文 · 源修订 15
💡
机制课: 机器人数据不是“图像加动作”的文件夹。它是一条带时间、坐标系、硬件、软件、任务、操作者、质量状态和因果关系的证据链。数据引擎的目标,是让每个模型都能追溯到它看过什么、怎样对齐、为什么被选中。
学习目标
完成本课后,应能设计 episode schema;处理多传感器时间同步、坐标系与动作语义;定义不可变数据版本和训练 manifest;建立 lineage、质量门禁、去重、切分与回放机制;判断数据规模增长是否真的增加有效信息。
1. Episode 是最小因果单元
一个 episode 应至少描述:
读法: 一次 episode 由观测序列、本体状态序列、动作序列、语言或任务描述、目标定义、元数据和结果共同组成。
推导: 策略监督不仅需要输入 O 和动作 A,还要知道机器人自身状态 Q、动作对应什么任务 L 与目标 G、采集和硬件条件 M,以及最终结果 R。把这些字段绑定为同一不可分割因果单元,才能重建当时模型可见信息、动作语义和成功判定。
只保存图像帧和动作会丢失任务边界、失败原因、控制频率、硬件状态和动作语义。episode schema 应能够回答:模型当时看到了什么、动作在什么坐标和单位中执行、为什么被判定成功或失败。
2. 时间同步决定监督是否正确
策略训练希望学习 对应的决策信息,但相机曝光、编码、网络、控制器和日志都有延迟。真实对齐可能是:
读法: 时刻 t 真正执行的动作,应与更早 delta_o 的观测和更早 delta_q 的本体状态配对,而不是按日志行号机械对齐。
推导: 决策链包含采集、编码、传输、推理和控制器缓存,因此动作生效时使用的是过去的感知状态。分别用硬件时间戳估计各信号相对动作生效时刻的延迟,就得到因果配对;若使用动作后的图像,训练会发生未来信息泄漏。
若把日志行号当成同一时刻,模型会学习“动作发生后的图像”预测动作,离线损失很低,部署时却失去因果输入。应保存设备时钟、主时钟、采样时间、到达时间和估计延迟。
3. 坐标系与动作 schema
| 字段 | 必须明确 |
|---|---|
| 参考系 | base、world、camera、tool、object |
| 动作类型 | 绝对/增量,位置/速度/力矩/阻抗 |
| 旋转表示 | Euler、axis-angle、quaternion、6D |
| 单位 | m/mm、rad/degree、N/Nm |
| 频率 | 原始采样、策略频率、控制频率 |
| 夹爪语义 | 宽度、速度、力或离散开合 |
跨本体训练时,padding 只是张量兼容;schema 才说明每一维在物理上是什么。
4. 数据版本不是文件夹日期
一个可复现数据版本应由内容寻址 manifest 定义:
读法: 数据版本是 episode 内容哈希、schema、全部变换、过滤规则和切分规则经过确定性哈希函数得到的内容地址。
推导: 先为不可变 episode 内容计算摘要,再把有序清单和所有处理配置序列化为规范表示并继续哈希。任何输入字节、规则或顺序改变都会改变摘要;完全相同的事实与处理应得到同一版本,从而支持去重、缓存和审计。
任何过滤、重采样、标签修正、坐标变换或切分变化都必须产生新版本,不能原地覆盖。内容地址还要求规范化序列化和固定哈希算法,否则同一清单可能因字段顺序不同得到不同摘要。
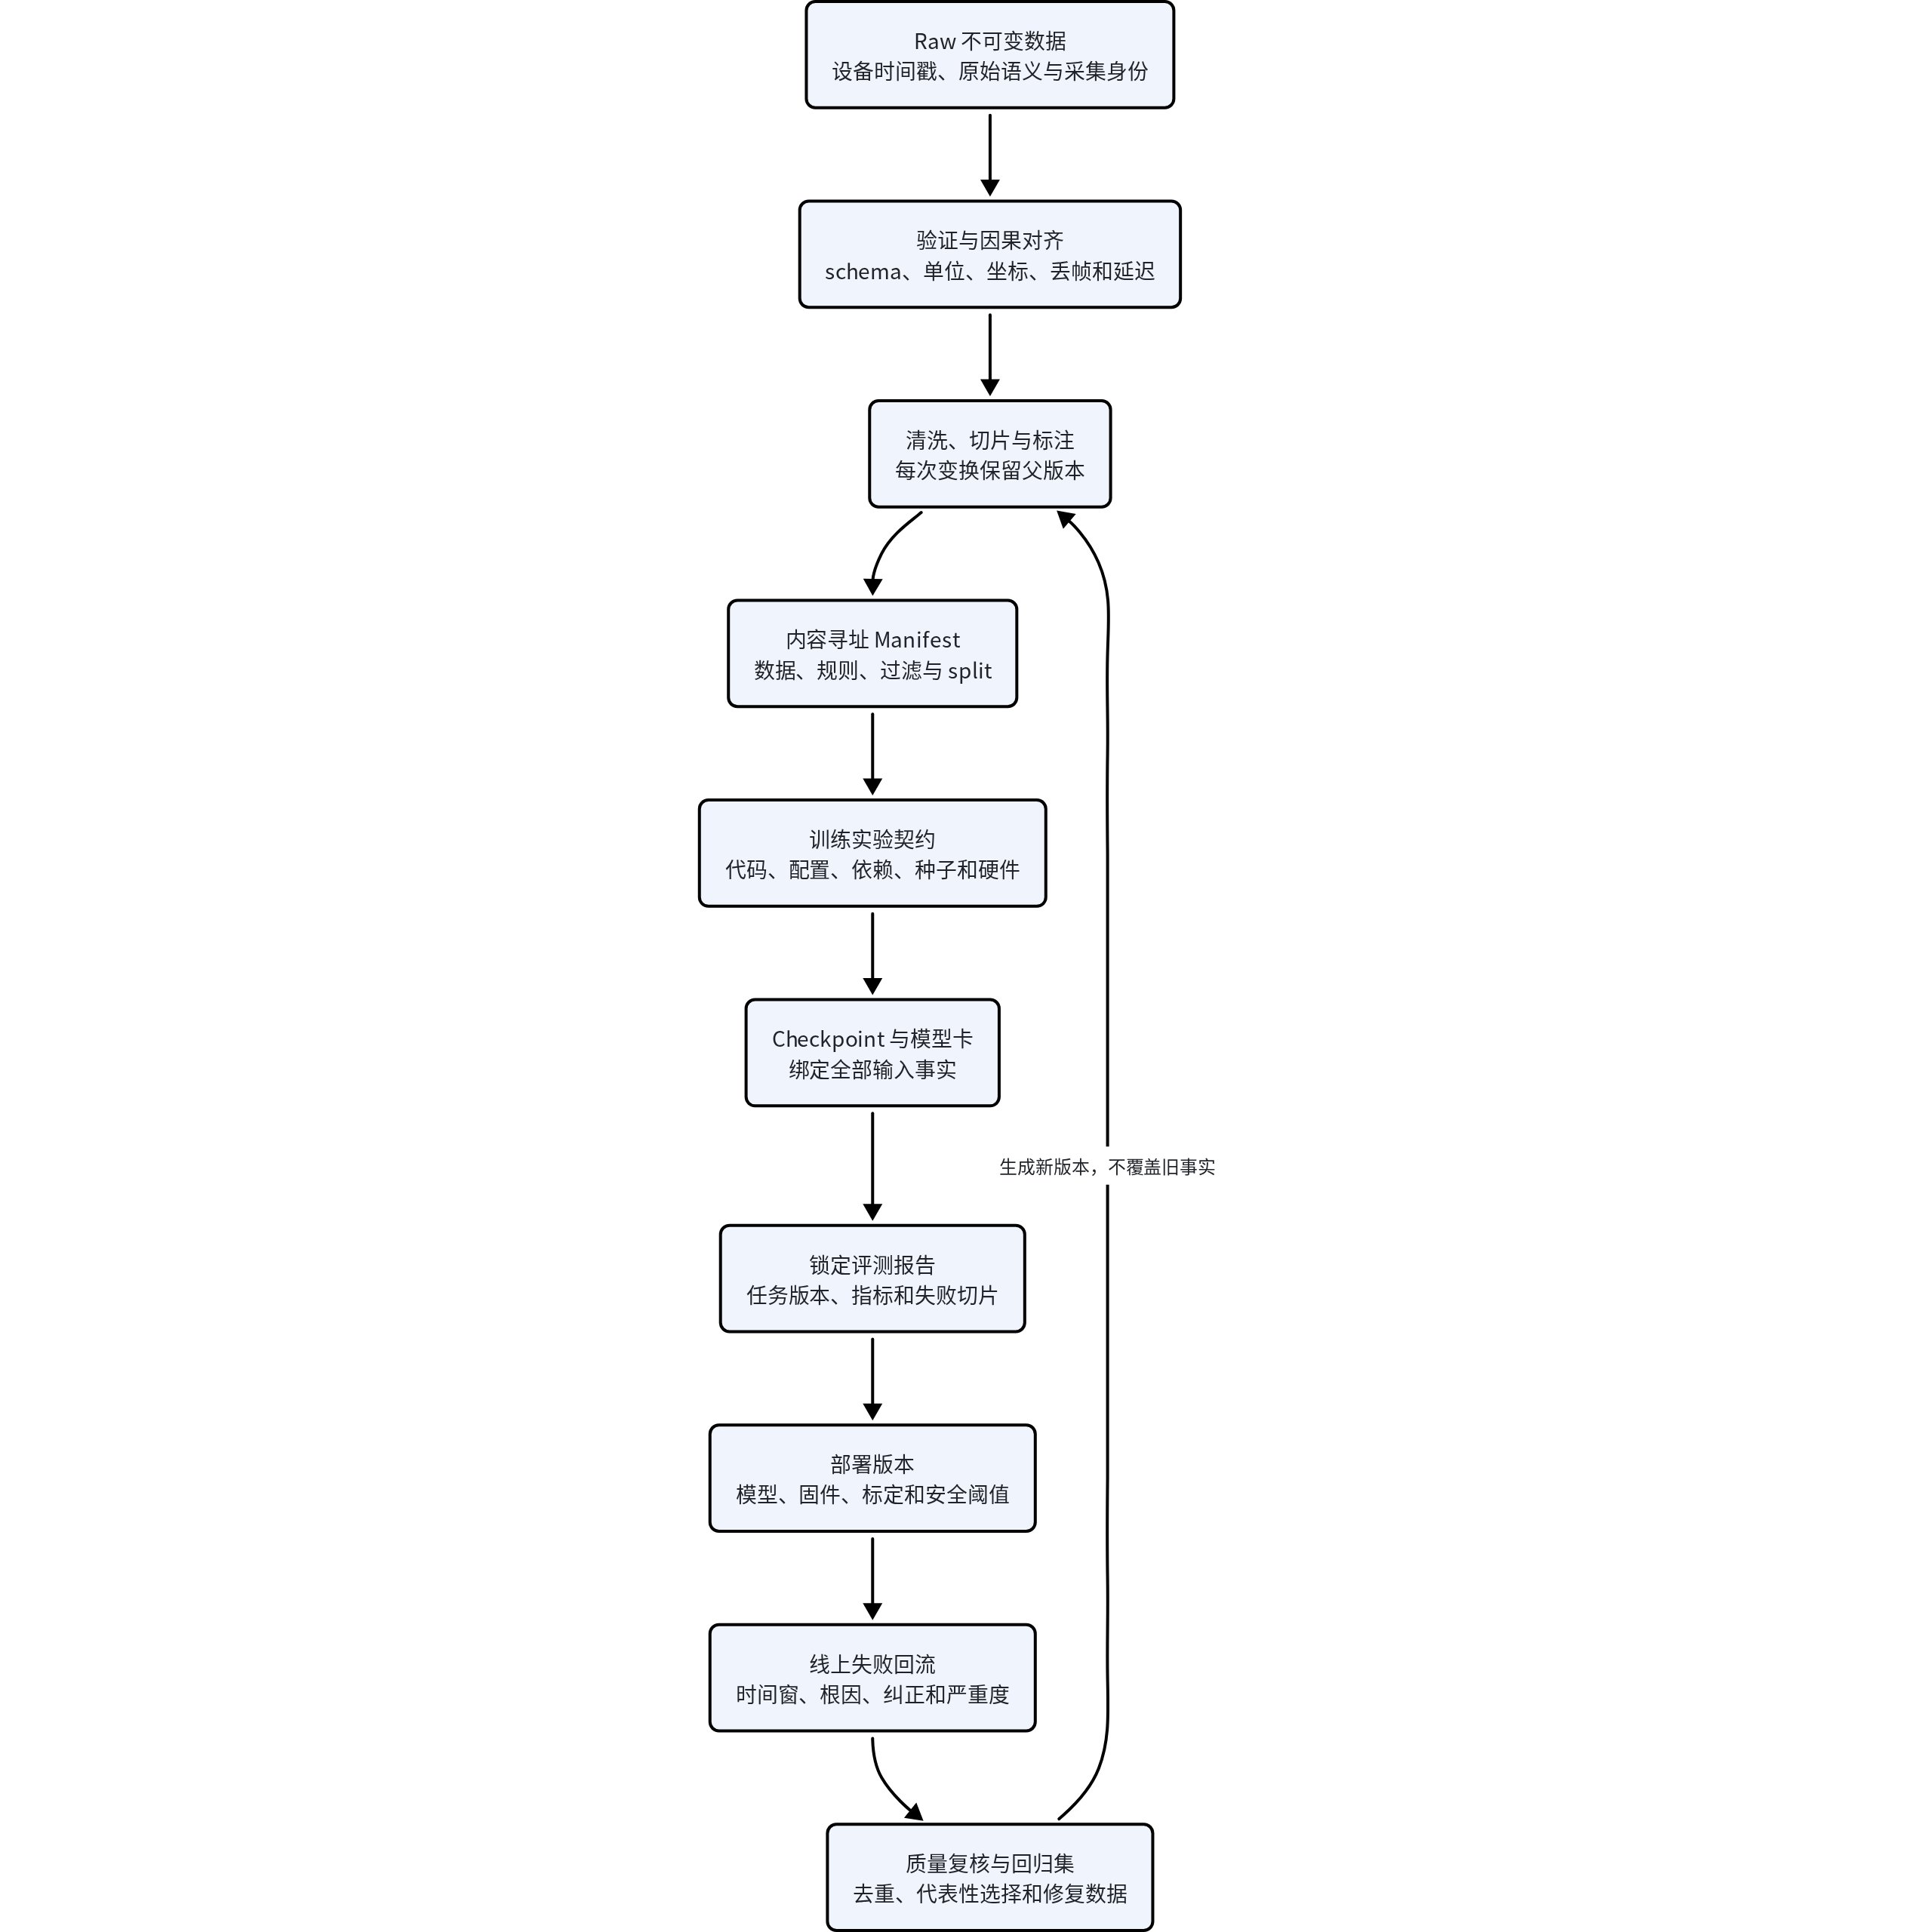
5. 训练实验契约
模型 artifact 必须绑定:
- 代码 commit、容器镜像和依赖锁。
- 数据 manifest 与采样权重。
- 模型结构、初始化 checkpoint 与 tokenizer。
- 优化器、学习率计划、随机种子和精度模式。
- 硬件拓扑、batch 语义和梯度累积。
- 评测代码、任务版本和发布门限。
“同样的 YAML”并不保证复现,若底层数据、依赖、预训练权重或非确定算子不同。
6. 数据质量是多维的
| 维度 | 例子 | 检测 |
|---|---|---|
| 完整性 | 掉帧、缺动作、截断 | 序列长度与时间戳单调性 |
| 一致性 | 单位错、坐标错、夹爪反向 | schema 验证与物理边界 |
| 因果对齐 | 图像晚于动作 | 延迟扫描与互相关 |
| 任务有效性 | 语言与轨迹不匹配 | 抽检、模型辅助与回放 |
| 覆盖 | 对象/失败/操作者单一 | 分布报表和嵌入可视化 |
7. 去重、泄漏与切分
相邻帧相似不等于数据泄漏,真正危险的是同一 episode、同一采集脚本或近重复对象同时进入训练与测试。切分应在因果上游完成,例如按对象实例、场景、操作者、机器人、日期或采集批次 group split。
近重复检测可结合内容 hash、感知 hash、轨迹特征和元数据键。任何自动去重都需保留审计日志,避免把关键但相似的恢复动作删除。
8. 数据混合与有效样本量
多源训练常采用:
读法: 数据源 d 的采样概率等于人工权重乘数据量的 alpha 次方,再除以所有数据源同类得分之和。
推导: 原始规模采样对应 alpha 等于一,所有数据源近似等概率对应 alpha 等于零。用 n_d 的幂次在两者之间插值,再乘人工质量或任务权重 w_d,最后归一化为概率分布。该式控制被看见的次数,不代表每条数据提供等量新信息。
alpha 小于一可以防止大数据源完全淹没小而重要的数据,但团队仍需报告每个来源实际被采样的次数、独立任务和对象覆盖,以及重复轨迹造成的信息折损,而不是只给原始小时数。
有效样本量。 若样本在训练或评测中带权,权重高度集中会降低真正的信息量。归一化前权重为 omega_i 时:
读法: 有效样本量等于权重总和的平方,除以权重平方和。
推导: 独立同方差样本的加权均值方差与权重平方和成正比。把该方差与 N_eff 个等权样本均值的方差相等,整理即可得到公式。所有权重相等时 N_eff 等于样本数;少数样本占据大权重时 N_eff 显著下降。
9. 失败数据如何进入下一版本
失败回流应经历:触发采集、自动聚类、严重度分级、根因标注、代表性选择、修复数据设计、再训练和针对性回归。直接把所有失败加权训练会放大重复模式,也可能教会模型接近失败状态而没有恢复标签。
10. 最小数据引擎实验
测试数据。 生成一批包含视觉、本体、动作、任务、结果和完整时间戳的 episode,并保留不可变 raw 层。随后注入已知错误,验证数据引擎能否发现、隔离和追溯。
| 注入或操作 | 必须验证的不变量 | 输出指标 |
|---|---|---|
| 图像错位 100 ms、控制时间戳漂移和丢帧 | 对齐器不能用未来观测配动作,且能标记不确定时间窗 | 延迟估计误差、错位检出率和误报率 |
| 米/毫米、度/弧度、base/world 坐标混淆 | schema 验证和物理边界能在训练前阻断错误 | 字段级命中率、漏检类型和受影响 episode |
| 复制 episode、近重复恢复轨迹和同 burst 切分 | 去重保留审计日志,group split 阻止因果上游泄漏 | 重复召回率、误删率和 train-test 相似度 |
| 修改标签、过滤器、变换或 split | 每次变化生成新内容地址,旧版本仍可完整读取 | 版本确定性、差异清单和回滚成功率 |
| 改变数据混合权重与 alpha | manifest 记录期望和实际采样分布 | 各源采样次数、任务覆盖与有效样本量 |
| 从 checkpoint 反向查询 | 能定位数据版本、代码、配置、初始化、硬件和评测协议 | 血缘完整率和缺失边数量 |
最小输出。 版本差异报告、数据质量仪表、split 泄漏报告、实际混合分布、lineage 有向图,以及从一次线上失败到修复数据、新模型和回归测试的完整追踪记录。
通过条件。 raw 数据不可变;版本哈希可重复;任何 checkpoint 可逆向追溯;已知错误的 validator 召回率达到预设门槛;测试集与训练集不存在同源 burst、对象实例或人工纠正泄漏。
11. 失效模式
| 失效模式 | 直接后果 | 决定性检查 | 修复 |
|---|---|---|---|
| 清洗脚本原地覆盖 raw 数据 | 原始事实无法恢复,所有后续版本失去审计基础 | 检查对象存储不可变策略和写入日志 | raw 只追加;变换产物写新层并记录父版本 |
| 标签修正沿用旧版本号 | 同一版本名对应不同训练事实 | 重新计算内容哈希并比对 manifest | 内容寻址;标签与规则变更强制新版本 |
| 训练和测试共享采集 burst | 背景、操作者和轨迹模板泄漏,离线分数虚高 | 按 burst、日期、对象和操作者做 lineage 交集 | 在因果上游 group split,切分后再生成帧 |
| 只统计数据小时数 | 重复静止段和单一任务被当作规模增长 | 报告独立 episode、任务、对象、动作熵和 N_eff | 按有效覆盖和边际收益决定采集优先级 |
| 跨机器人归一化丢失单位和限位 | 相同张量维度对应不同物理命令 | 从规范动作反解回原机器人并做回放 | 保留本体适配器版本、单位、坐标和有效 mask |
| 部署日志无法关联模型与固件 | 线上回归无法复现,也无法判断算法还是系统问题 | 随机抽取失败回放完整 lineage | 运行时写入模型、配置、固件、标定和数据版本 |
12. 本课练习
- 为双臂机器人定义可跨硬件扩展的动作 schema。
- 解释采样时间与到达时间为什么都要保存。
- 设计一个防止对象实例泄漏的切分规则。
- 推导温度采样中 和 的含义。
- 画出一次线上失败到新模型发布的完整 lineage。
与其他路线的关系
路线 E 决定哪些表征能跨本体,G2 保证原始语义没有在管道中丢失;路线 A/B/C/D 的监督信号都依赖 episode 契约;路线 F 的控制频率、时间戳和硬件版本是数据 schema 的一部分。
13. 数据治理与机器人数据论文证据矩阵
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| Gebru et al.|Datasheets for Datasets | 该工作提出用标准文档记录数据集动机、组成、采集、预处理、用途和维护。 | 作者把数据集视为需要责任边界和使用说明的工程产物,而不是匿名文件。 | 机器人 datasheet 还必须增加动作语义、坐标、频率、本体、时间同步和安全标签。 |
| Sambasivan et al.|Data Cascades | 该研究记录高风险 AI 项目中上游数据问题如何在下游形成长期、复合和难以修复的故障。 | 作者强调数据工作的低可见性和组织激励会放大技术债。 | validator 不是一次清洗脚本;数据责任、版本和回流流程必须成为持续系统。 |
| Polyzotis et al.|Production ML Data Management | 该工作总结生产机器学习中的数据验证、特征、血缘、训练服务和偏差管理挑战。 | 作者指出模型行为依赖数据与代码共同形成的复杂生产图。 | checkpoint 本身不是可复现 artifact,必须绑定数据、代码、配置、依赖和评测。 |
| Open X-Embodiment | 该工作统一多来源机器人数据并训练跨本体 RT-X 策略。 | 作者通过标准化数据格式和异构混合探索跨机器人迁移。 | 张量对齐不等于语义对齐;本体适配器和原始动作契约必须版本化。 |
| DROID | DROID 建立标准化真实机器人采集系统,覆盖多场景、多任务与多操作者。 | 作者用统一硬件和采集协议降低跨站点数据差异。 | 统一平台仍需记录站点、操作者、标定、固件和时间同步,才能做真实留出。 |
| RoboMimic | RoboMimic 展示离线机器人学习结果对数据质量、观测和训练设置高度敏感。 | 作者用统一基准拆分算法与数据因素。 | 数据版本、预处理和初态评测不锁定时,“复现算法”没有可比意义。 |
14. 交叉阅读
与路线 E 连读。 跨本体学习依赖本体适配器和原始动作语义不在标准化过程中丢失。
与 F3 连读。 时间对齐、执行器版本和系统辨识参数既是控制事实,也是数据 schema。
与 G1 连读。 切分和去重决定统计试验是否独立,数据血缘决定多重试验和选择过程能否被审计。
与 G3-G4 连读。 部署监控产生的数据只有绑定模型、固件和失败根因,才能进入安全的再训练与回滚流程。