

飞书原文 · 源修订 12
💡
机制课: 动作 Tokenizer 压缩机器人控制,Behavior Tokenizer 还希望统一人类视频、事件、技能与跨本体行为。本课讨论 token 的层级、训练目标、codebook、事件边界和机器人解码。
学习目标
完成本课后,应能区分动作 token、事件 token、技能 token 和意图 token;推导 VQ 目标;分析 codebook 塌缩;设计分层 Tokenizer 和跨本体解码;建立控制相关评测。
1. Tokenizer 的目标
编码:
读法: Tokenizer T 把连续行为轨迹 tau 编码为长度 M 的 token 序列。
推导: 长轨迹包含高频动作、事件边界和任务结构。编码器用更短序列压缩这些信息;压缩是否有用不能只看长度,还要看 token 能否预测、组合并被机器人解码。
解码:
读法: 解码器 D 根据 token 序列和本体标识 e,重建该本体上的行为轨迹。
推导: 共享 token 应表达功能或事件,而不同机器人用不同动作空间实现同一功能。把 e 放入解码器,可以让高层词表共享、低层控制保持本体特异。
表示本体。Tokenizer 需要压缩、预测和重建,同时保留任务、事件和控制信息。
2. 四层 token
| 层级 | 例子 | 时间尺度 |
|---|---|---|
| 低层动作 | 末端增量、关节变化 | 毫秒到秒 |
| 运动原语 | 接近、抬起、旋转 | 秒 |
| 交互事件 | 接触、抓稳、释放 | 秒 |
| 技能/意图 | 抓杯子、开抽屉 | 数秒到分钟 |
单层词表很难同时表达精细动作和高层组合。分层 Tokenizer 更符合行为的多时间尺度结构。
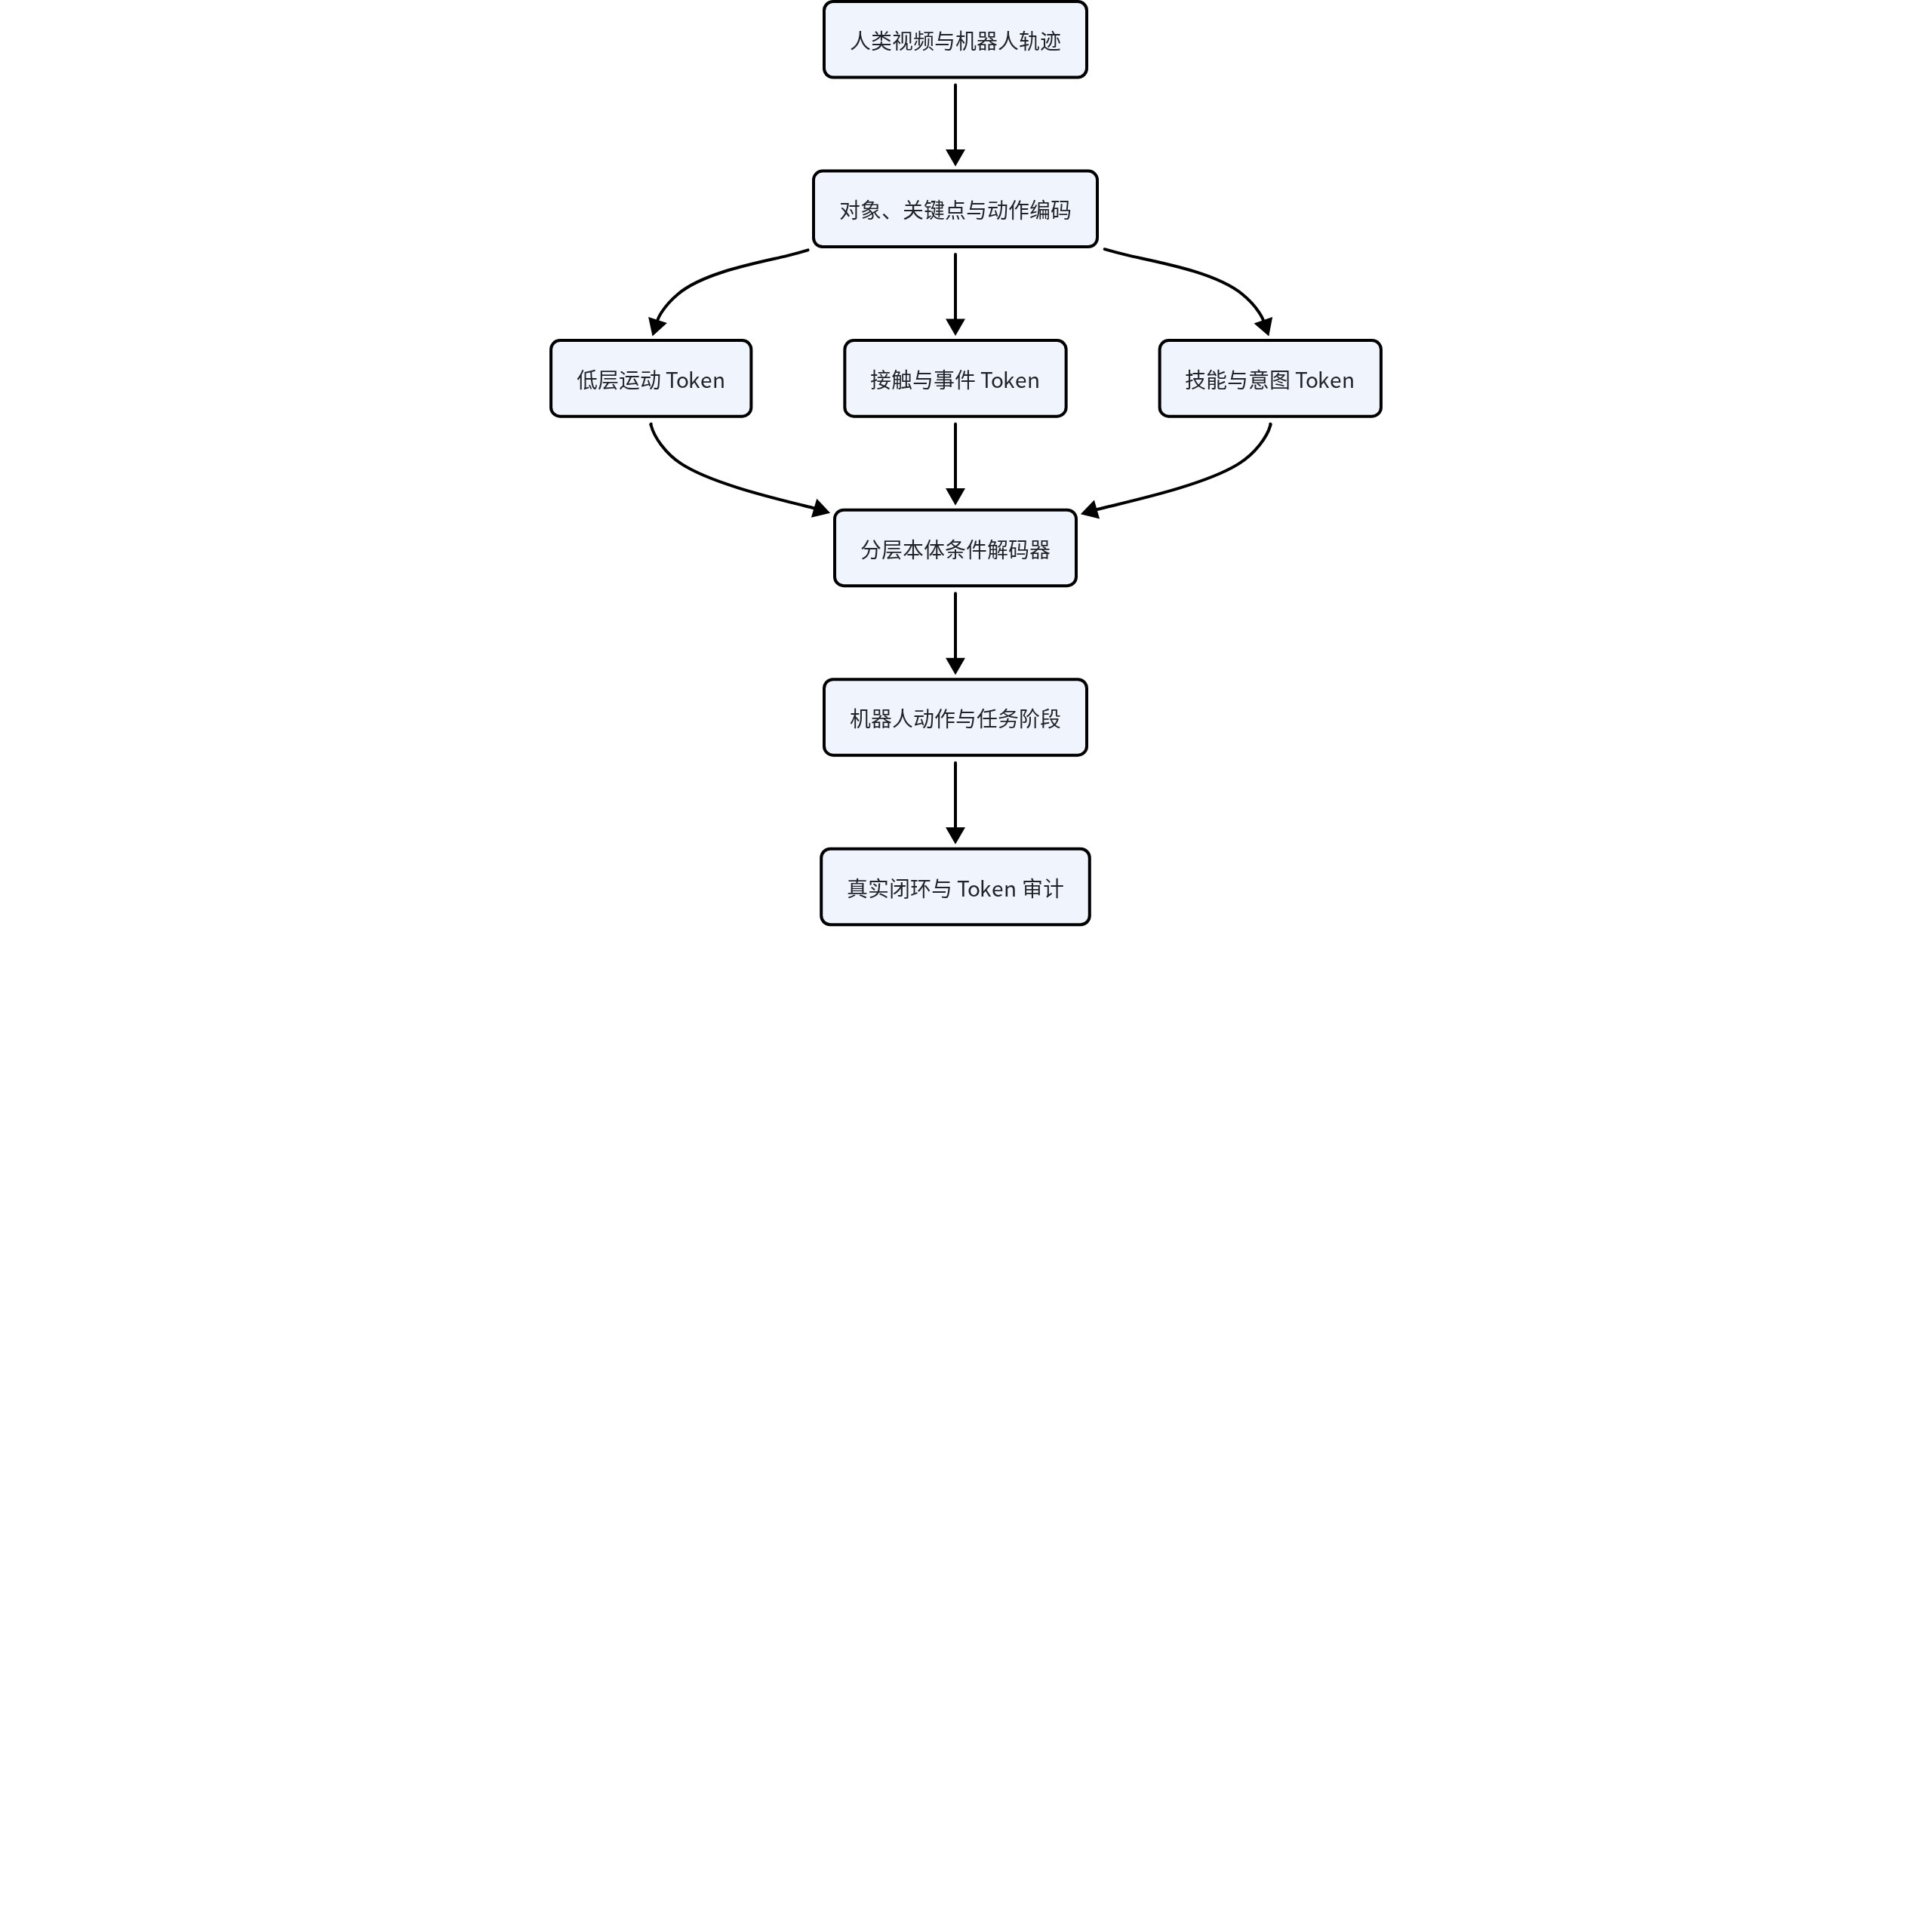
3. Vector Quantization
连续编码 映射到最近 code:
读法: 选择与连续编码 h 欧氏距离最近的 codebook 向量,其编号记为 k star。
推导: 向量量化用最近邻把连续空间划分为离散 Voronoi 区域。编码 h 落在哪个区域,就输出对应 token;距离度量和编码尺度会直接决定分区语义。
VQ-VAE 目标包含重建、codebook 和 commitment:
读法: VQ 损失由重建项、把最近 code 拉向编码的 codebook 项,以及让编码承诺靠近所选 code 的 commitment 项组成。
推导: 第二项对 h 停梯度,只更新 e_{k^*};第三项对 code 停梯度,只推动 encoder 输出靠近该 code。重建项保证 token 保留轨迹信息,beta 控制 encoder 不在 code 边界间频繁跳动。
表示 stop-gradient。
4. Codebook 塌缩
少数 token 被频繁使用,其他 token 空闲。可检查:
- 使用率和 perplexity。
- 任务/本体条件下的 token 熵。
- 重复 code 和死 code。
- token 与事件的互信息。
扩大 codebook 不会自动增加语义,可能只增加未使用 token。
5. 时间分段
| 分段 | 优点 | 风险 |
|---|---|---|
| 固定窗口 | 简单并行 | 切断事件 |
| 速度变化 | 捕捉运动边界 | 抖动产生伪边界 |
| 接触事件 | 物理意义强 | 需要传感 |
| 变化点检测 | 数据驱动 | 与任务语义不一致 |
| 学习 termination | 端到端 | 难稳定和解释 |
6. 训练目标
除了重建,还可使用:
读法: 总损失把重建、预测、对比、事件边界和跨本体对齐五类目标加权相加。
推导: 重建保存细节,预测要求 token 对未来有用,对比目标组织语义邻域,事件目标塑造时间边界,对齐目标连接人类与机器人。各 lambda 必须通过下游任务和梯度尺度平衡,不能只优化某一离线指标。
- 预测下一 token 或未来状态。
- 跨视角相同事件一致。
- 事件标签监督。
- 人类和机器人行为对齐。
- 任务结果与价值。
7. 人类与机器人共享什么 token
共享高层事件和对象变化,保留低层本体差异。可以让共享 token 经本体条件解码:
读法: 本体条件解码器根据共享行为 token、当前本体观测和本体标识,对该机器人的动作建模。
推导: 同一 token 在不同身体上对应不同关节命令,因此解码必须读取本体状态。固定 token、替换 e 并在留出机器人上训练少量 adapter,可检验词表是否真的共享功能语义。
若共享词表只靠 BPE 统计共现,可能共享字符串而非行为语义。必须做跨本体检索和闭环解码。
8. FAST 与 Behavior Tokenizer 的关系
FAST 对连续机器人动作做频域压缩和 BPE,目标是高效自回归动作建模。Behavior Tokenizer 的范围更广,还包含人类视频、事件、技能和跨本体语义。
FAST 可以作为低层动作层,高层 Behavior Token 提供事件或技能条件。
9. 评测
| 层 | 指标 |
|---|---|
| 压缩 | token 长度、熵、perplexity |
| 重建 | 动作、轨迹、事件误差 |
| 预测 | 下一 token 和未来状态 |
| 语义 | 任务、对象、阶段探针 |
| 迁移 | 跨本体检索和少样本解码 |
| 控制 | 真实成功、平滑、接触和恢复 |
10. 最小实验:Token 是否保留任务与控制语义
在同一批多阶段操作轨迹上比较固定窗口、事件分段、VQ token、连续 latent 和混合离散-连续 token。固定编码器容量、总码率、训练数据和下游策略。
报告轨迹重建、未来预测、codebook perplexity、事件边界 F1、token 与对象状态变化的互信息、跨视角检索、留出机器人少样本解码,以及真实闭环成功率。额外做 token 置换和动作解码冻结,确认策略真正使用 token。
11. 本课练习
- 推导 VQ-VAE 三项损失。
- 设计 token 使用率和 codebook 塌缩诊断。
- 比较固定窗口和接触事件分段。
- 设计人类与机器人共享高层 token 的实验。
- 解释 FAST 不等于完整 Behavior Tokenizer。
- 定义混合离散技能 token 与连续动作参数。
12. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| Codebook 塌缩 | 少数 token 占据绝大多数轨迹 | 使用率、perplexity、重启空 code 和均衡采样 |
| Token 碎片化 | 同一事件因微小速度差被拆成大量 token | 事件监督、时间一致性和层级 token |
| 只保留抖动 | 重建误差低,但对象状态和任务阶段不可预测 | 对象、事件、未来预测和控制损失 |
| 边界错位 | token 在接触或释放中间切换,技能不可组合 | 事件边界 F1、迟滞和变长分段 |
| 字符串共享假象 | 人类与机器人使用同一 token 编号但含义不同 | 跨本体检索、反事实置换和留出本体解码 |
| 解码器忽略 token | 置换 token 后动作几乎不变 | token 干预、条件互信息和解码器容量控制 |
| 码率比较不公平 | 方法因 token 数更多而获得额外信息容量 | 固定 bits/step、序列长度和计算预算 |
13. 论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| VQ-VAE | 用离散 codebook 和重建目标学习离散潜变量,并通过 stop-gradient 训练 | 离散表示可连接连续数据与自回归序列模型 | 提供量化地基,但 code 是否具有行为语义取决于数据、分段和下游目标 |
| FAST | 对连续机器人动作做频域变换与 BPE 压缩,提高自回归 VLA 动作建模效率 | 更合适的动作 token 能缩短序列并改善训练 | FAST 主要解决机器人低层动作压缩,不等同于跨人类视频、事件和技能的完整 Behavior Tokenizer |
| Genie | 从视频学习离散 latent action 并用于可交互未来生成 | 离散行为变量可以从无动作视频中发现 | 视觉可控 token 不自动具有机器人控制语义,仍需 adapter 与闭环验证 |
| XSkill | 学习人类与机器人视频间的跨本体技能表示 | 技能级语义可以跨不同身体共享 | 需用事件边界、留出本体和真实解码证明共享,而非只看 embedding |