

飞书原文 · 源修订 10
🔬
论文实验室: 统一比较人类视频进入机器人学习的五种机制:表征预训练、轨迹/点预测、高层计划、人体动作重定向、测试时适应。
统一比较框架
| 维度 | 问题 |
|---|---|
| 人类数据 | 无动作视频、关键点、动作捕捉还是演示 |
| 中间变量 | 表征、轨迹、技能、伪动作、快速记忆 |
| 机器人监督 | 多少动作数据和配对任务 |
| 对齐 | 视觉、对象、事件、时间或本体 |
| 证据 | 少样本、跨环境、真实机器人和任务留出 |
1. R3M / VIP:视觉表征预训练
利用大规模人类视频学习时间和语言相关视觉表示,再供机器人策略使用。优势是通用和简单;局限是表征提升不等于动作监督,控制收益依赖后续机器人数据。
2. MimicPlay:人类视频作为高层计划
从人类演示学习高层计划表示,机器人低层策略执行。它避免直接映射人类动作到机器人关节,强调视觉任务进度和层级分工。
3. ATM:任意点未来轨迹
从视频预测图像点的未来轨迹,提供对象和局部运动线索。轨迹比像素生成更紧凑,但仍需把二维点运动转成机器人可执行动作。
4. 视频生成作为计划空间
语言条件生成未来视频或视觉子目标,再由机器人策略跟随。优点是可利用互联网视频;风险是生成未来物理不一致、不可达或与目标本体不匹配。
5. HumanPlus / OmniH2O:人体动作到人形机器人
利用人体动作、动作捕捉和重定向训练人形机器人。人形本体与人体结构接近,动作对齐更直接,但质量、接触、关节限制和控制稳定性仍不同。
6. WAM-TTT:测试时人类视频写入行为记忆
不是把人类视频直接转成动作,而是在 meta-training 中学习“什么样的人类侧更新能改善机器人任务”。关键是 inner/outer loop 和人机任务对应。
7. 方法对比
| 方法 | 中间变量 | 机器人数据 | 主要风险 |
|---|---|---|---|
| R3M/VIP | 视觉表示 | 后续策略数据 | 表征与控制脱节 |
| MimicPlay | 高层计划 | 低层执行 | 计划落地 |
| ATM | 点轨迹 | 动作适配 | 2D/3D 和接触 |
| 视频生成 | 未来视觉 | 低层跟随 | 物理幻觉 |
| HumanPlus | 人体动作 | 重定向与控制 | 动力学差异 |
| WAM-TTT | 快速记忆 | meta-training 配对 | 记忆污染和同步假设 |
8. 统一实验协议
- 固定机器人数据预算。
- 比较不使用人类数据基线。
- 分别加入表征、轨迹、计划、伪动作和记忆。
- 严格留出对象、环境和任务结构。
- 做人类视频时间打乱和无关视频对照。
- 报告机器人闭环成功和恢复。
9. 本实验室作业
- 为六种方法画“人类数据 → 中间变量 → 机器人动作”图。
- 区分表征迁移和动作迁移。
- 设计视频物理幻觉实验。
- 比较人形机器人与机械臂的跨本体假设。
- 为 WAM-TTT 设计错误演示对照。
- 制作证据矩阵,标注真实机器人任务和数据泄漏风险。
现有专题资料
实验室加深|统一公式、可视化与复现
人类视频、机器人轨迹、潜在动作与跨本体共训练可以统一成带数据源和 embodiment 条件的表示学习:
读法: 编码器根据最近一段观测、数据源标识 d 和本体描述 e,提取共享表示 z_t。
推导: 历史窗口提供运动和阶段信息,d 区分人类视频、机器人轨迹等监督来源,e 描述身体与传感器。若 z 只记住 d 或 e 而不保留任务功能,严格留出本体上不会产生迁移收益。
读法: 解码器根据共享表示和目标本体 e star,预测该目标本体的动作、子目标或状态变化。
推导: 共享表示必须通过目标本体条件重新解释为具体输出。把 e_star 设为训练中未出现的机器人,并只给少量 adapter 数据,是检验跨本体语义是否真实存在的关键实验。
读作:“先从不同来源和不同身体的观测中抽取任务相关状态,再为目标机器人解码动作、子目标或动态变化。”关键不是 latent 是否共享,而是共享后是否提高严格留出下的目标任务表现。
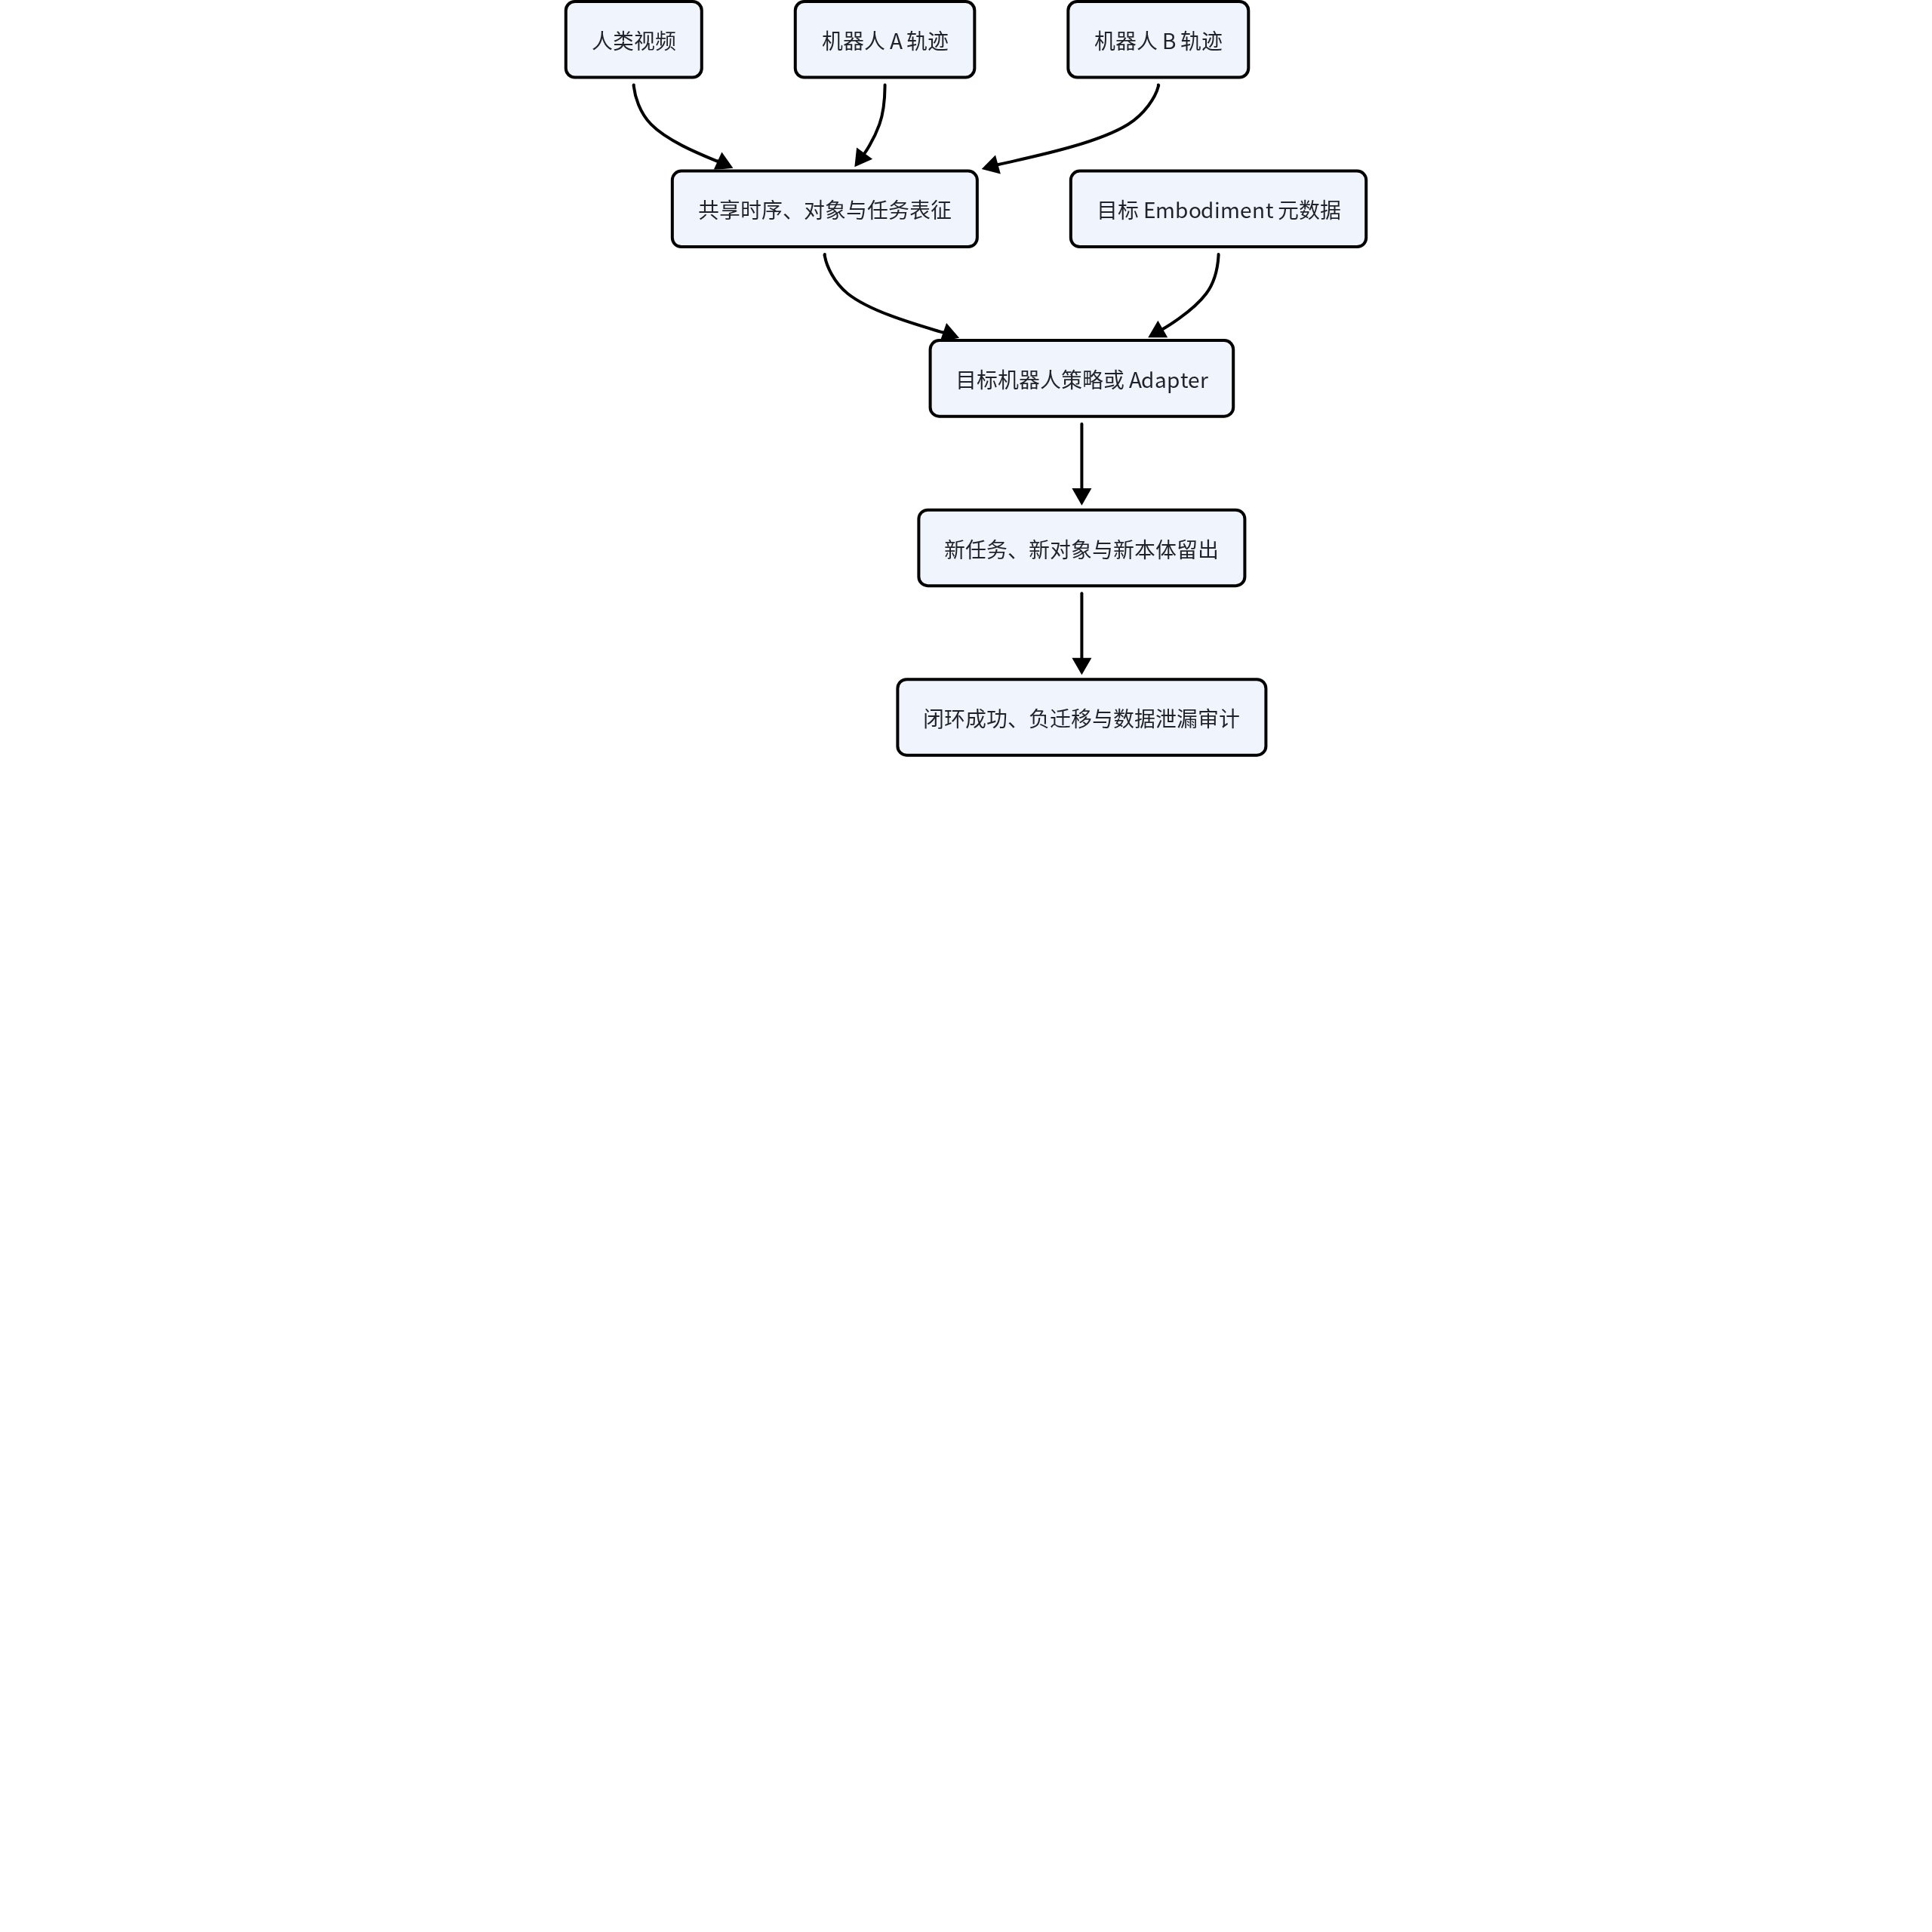
最小实验:统一复现协议
固定目标机器人标注量、模型容量、总训练计算和推理预算,逐步加入人类视频、其他机器人数据和不同中间变量。对象、任务组合和目标本体必须独立留出,并报告目标数据量与成功率曲线。
- 固定目标机器人标注量,逐步加入人类视频和其他机器人数据。
- 比较视觉预训练、时序对比、潜在动作、显式重定向和直接共训练。
- 使用对象、任务组合和 embodiment 三种独立留出。
- 画目标数据量与成功率曲线,检验外源数据是否提高样本效率而非只增加总计算。
实验室练习
- 构造一个 latent 能识别数据源但不能迁移任务的反例。
- 解释为什么未来帧预测可能学到运动,却不一定学到可执行动作。
- 设计一个区分对象中心迁移与 embodiment id 记忆的实验。
- 为人类视频定义不依赖速度标签的三种监督信号及其盲点。
主要失败模式
| 失败 | 表现 | 统一诊断 |
|---|---|---|
| 外源数据规模混淆 | 加入人类视频后提升,但总计算和数据也大幅增加 | 固定计算、机器人数据和模型容量 |
| 表征指标替代控制 | 线性探针提高,机器人成功率不变 | 冻结策略、少样本曲线和真实闭环 |
| 任务或对象泄漏 | 所谓新本体仍见过相同场景和动作模板 | 对象、任务、场景、本体四层去重 |
| 数据源分类捷径 | latent 能识别人类或机器人,却不能迁移任务 | 数据源对抗探针与目标任务探针对照 |
| 人体重定向不稳定 | 运动学跟踪好但接触、平衡和力控制失败 | 动态可行性、接触力、跌倒率和控制约束 |
| 视觉计划不可执行 | 未来视频合理但目标机器人无法到达 | 可达性、逆动力学和真实 rollout |
| 测试时记忆污染 | 错误或无关人类视频降低当前策略 | 错误演示、门控、影子更新和回滚 |
论文事实、作者解释与课程判断
| 工作 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| R3M / VIP | 从人类视频学习视觉表示或价值相关表示,并用于机器人下游任务 | 视频中的时序与交互信号可形成通用视觉先验 | 证明的是表示迁移,不能据此声称获得了机器人动作监督 |
| MimicPlay | 人类 play 提供高层任务引导,少量机器人演示负责低层执行 | 层级分工可以利用人类数据改善长时操作 | 应拆分高层计划质量、低层机器人数据和对象重复带来的贡献 |
| ATM / 视频计划 | 预测未来点轨迹或视觉未来,把观测空间未来作为策略条件 | 运动轨迹和视觉目标可作为紧凑计划空间 | 需要验证几何可达、接触正确以及策略是否真正使用预测 |
| HumanPlus / OmniH2O | 利用人体动作、动作捕捉和重定向训练人形机器人全身控制 | 人体结构先验可扩展人形机器人技能 | 相似本体降低映射难度,但动态平衡、接触和硬件约束仍需机器人控制数据 |
| WAM-TTT | 人类侧上下文在测试时写入快速记忆,机器人任务监督更新规则 | 当前人类演示可支持快速适应 | 关键证据是留出环境、错误演示对照、适配后旧任务保持与回滚 |