

飞书原文 · 源修订 34
💡
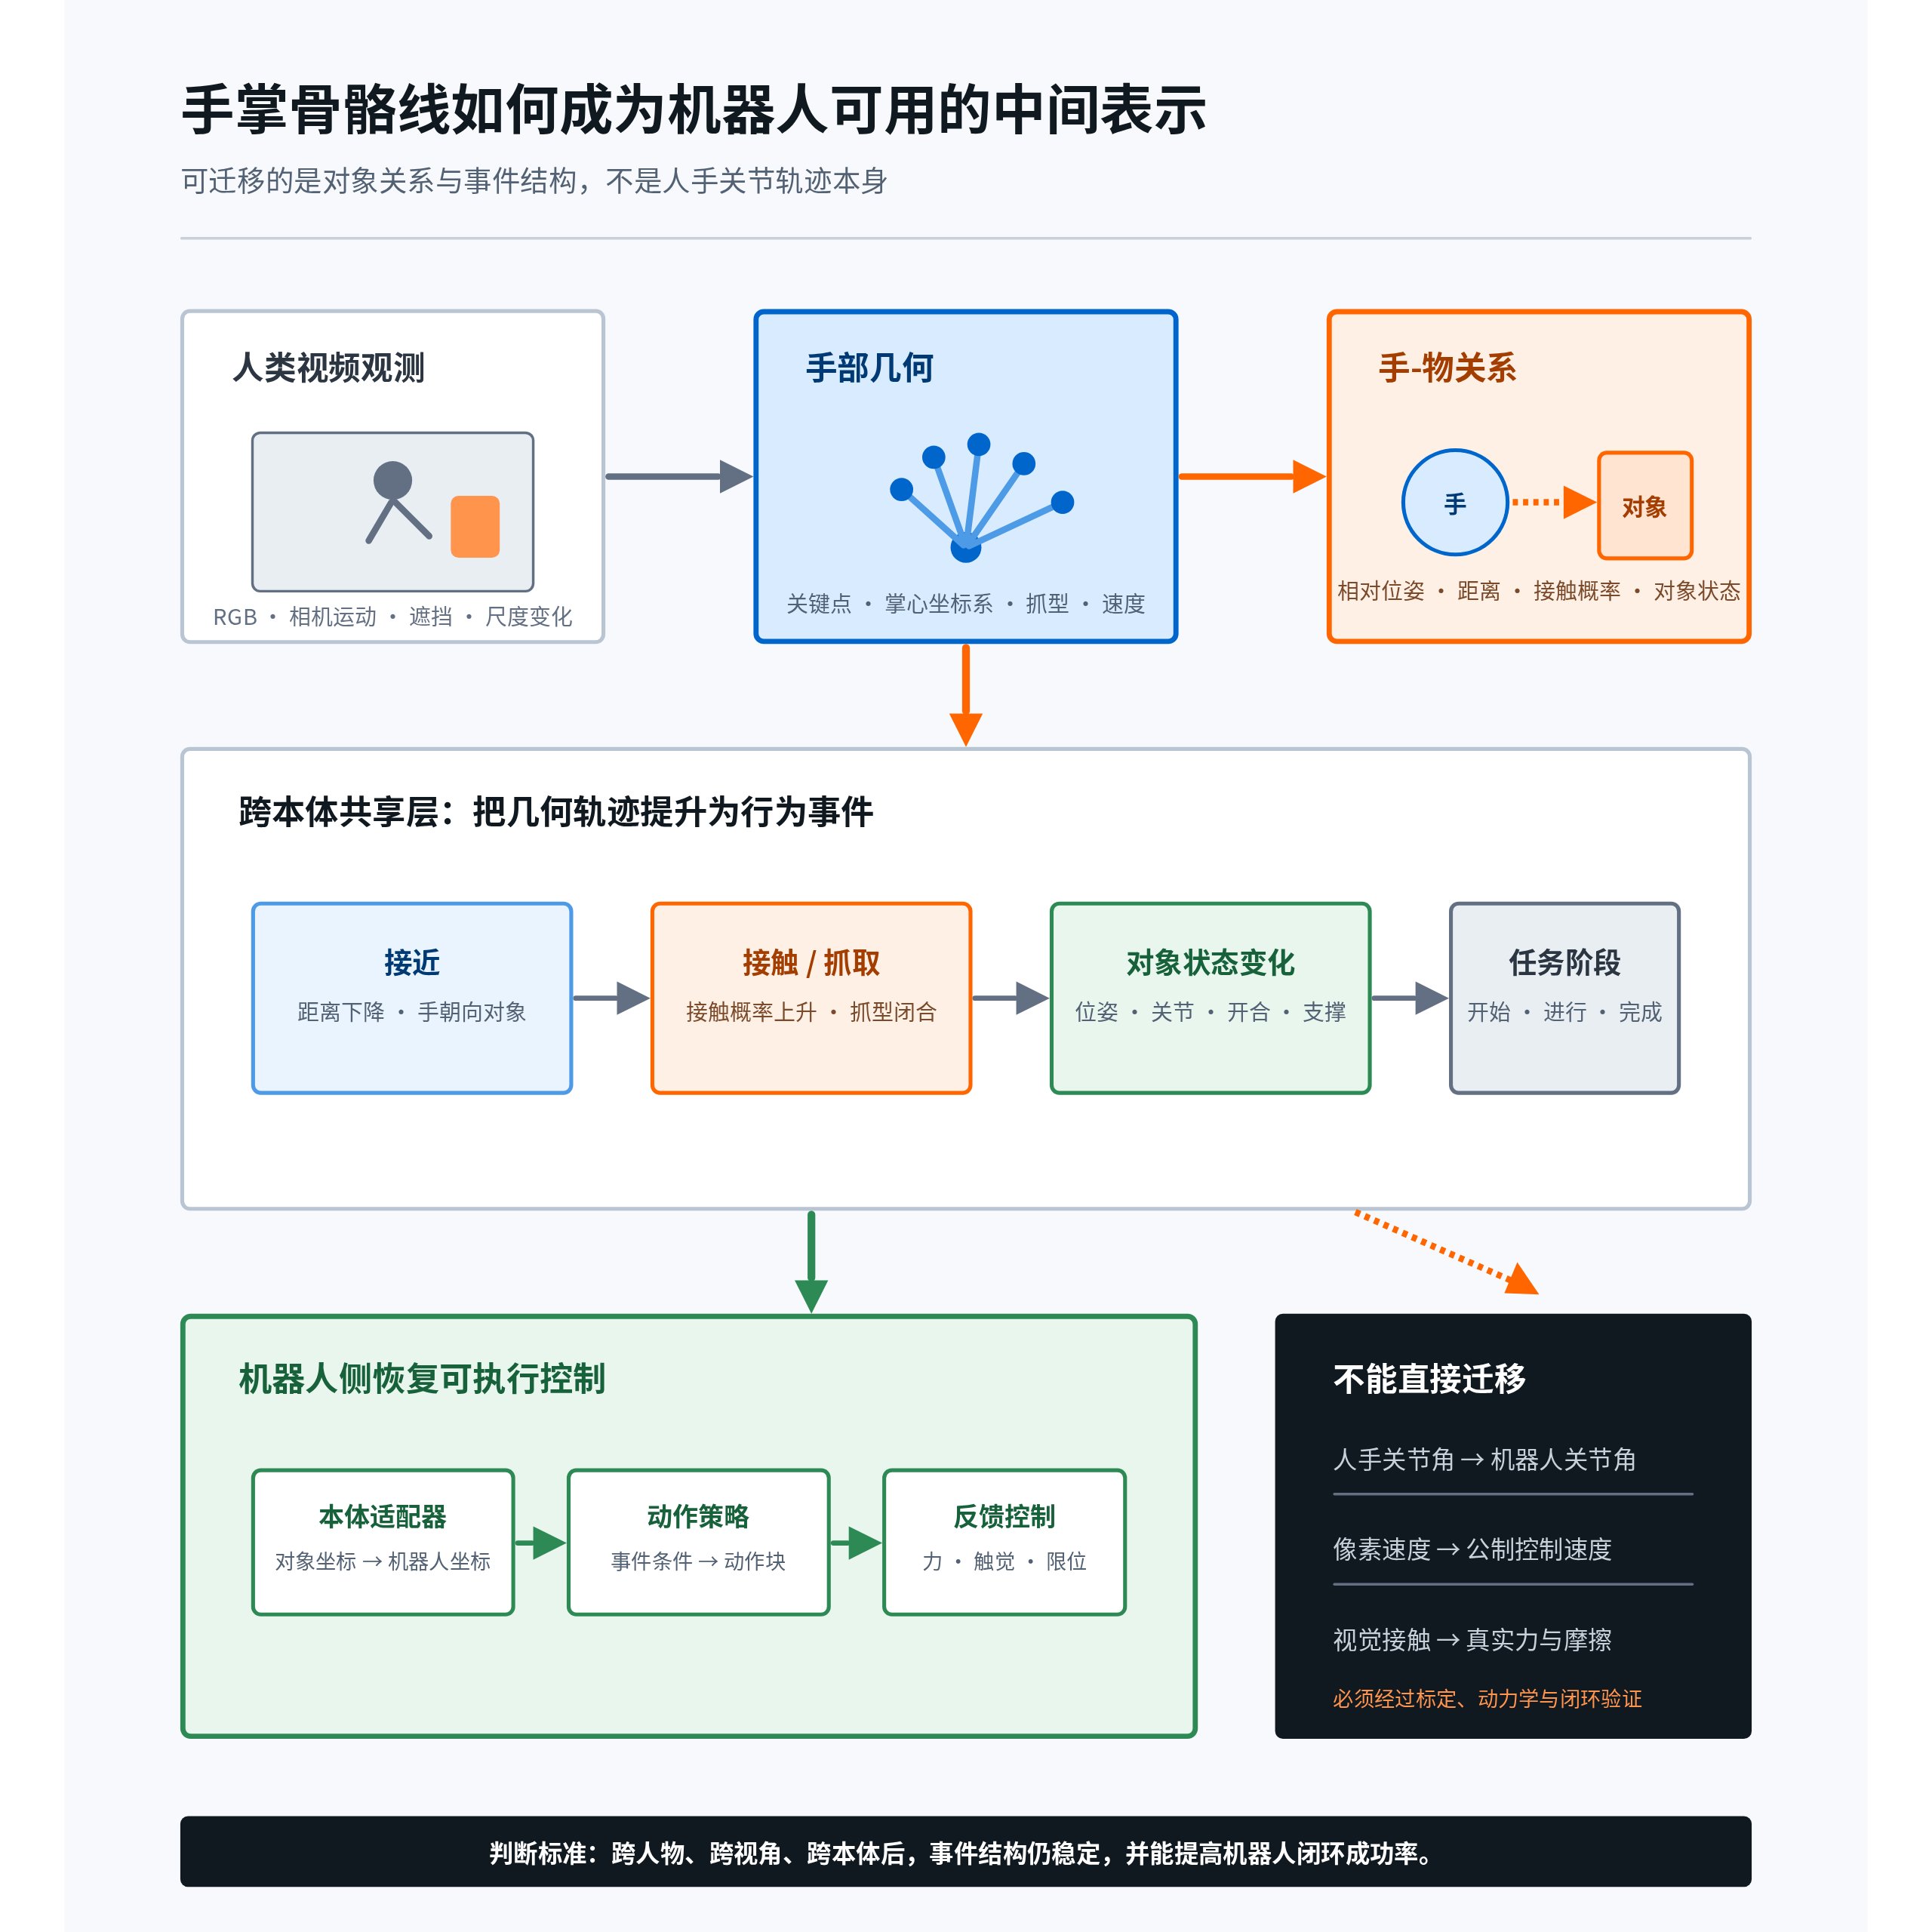
核心结论: 手掌骨骼线不是机器人动作标签,而是从人类视频中恢复“手在哪里、朝向哪里、以什么抓型接近哪个对象”的中间几何表示。真正适合跨人类与机器人迁移的变量,是对象坐标系中的手-物相对位姿、接触事件、对象状态变化与任务阶段。
1. 为什么需要手掌骨骼线
只有 RGB 视频时,模型看见的是像素变化。手部骨架把高维外观压缩为一组具有解剖拓扑的关键点,使跨人物、肤色、光照和背景的运动更容易比较。
| 层级 | 代表信号 | 能够回答的问题 | 不能直接回答的问题 |
|---|---|---|---|
| 像素 | RGB、光流、特征图 | 画面哪里发生变化 | 变化是否由手、相机或遮挡引起 |
| 手部骨架 | 2D/3D 关键点、置信度 | 手掌位置、朝向、指尖开合、运动趋势 | 真实力、摩擦、稳定接触、机器人关节命令 |
| 手-物关系 | 相对位姿、距离、接触概率、对象状态 | 手如何作用于对象、动作处于哪个阶段 | 未经标定时的绝对动力学真值 |
| 机器人控制 | q、dq、末端位姿、力矩、触觉 | 机器人下一步应执行什么 | 不能仅由人手骨架直接确定 |
关键边界: 骨架是视觉观测的结构化后处理结果。它可能来自预训练模型或离线标注,并不意味着原始人类视频一开始就带有关节速度、接触力或机器人动作。
2. 21 点手部骨架与骨骼连接
工程上最常用的表示之一是 MediaPipe Hands 的 21 个关键点。编号 0 为手腕;1–4 为拇指;5–8 为食指;9–12 为中指;13–16 为无名指;17–20 为小指。
| 区域 | 关键点 | 典型连接 | 主要用途 |
|---|---|---|---|
| 掌根 | 0, 5, 9, 13, 17 | 0-5, 5-9, 9-13, 13-17, 17-0 | 手掌中心、尺度、平面和朝向 |
| 拇指 | 1, 2, 3, 4 | 0-1-2-3-4 | 对掌、捏取和抓型区分 |
| 食指 | 5, 6, 7, 8 | 0-5-6-7-8 | 指向、按压、捏取 |
| 中指 | 9, 10, 11, 12 | 0-9-10-11-12 | 掌长、主方向、包络抓取 |
| 无名指 | 13, 14, 15, 16 | 0-13-14-15-16 | 抓型与包络程度 |
| 小指 | 17, 18, 19, 20 | 0-17-18-19-20 | 掌宽、侧向抓取与包络程度 |
每个观测点不应只存坐标,还应保留置信度:。其中 可能是相机坐标中的估计深度,也可能只是相对深度;两者不可混用。
读法: 第 t 帧的第 j 个手部关键点 h,由三维位置坐标 x、y、z 和关键点置信度 c 共同表示。这里的 z 只有在完成相机标定或尺度恢复后,才可以解释为真实深度。
3. 手掌坐标系:从关键点到可迁移几何
21 个点直接输入模型可以工作,但跨视角和跨形态迁移较差。更稳健的做法是先构造手掌局部坐标系。
设手腕为 ,食指掌指关节为 ,中指掌指关节为 ,小指掌指关节为 :
读法: p 下标 0、5、9、17 分别表示手腕、食指掌指关节、中指掌指关节和小指掌指关节的位置;后续用这四个点建立手掌局部坐标系。
读法: 把手掌坐标系的原点 o_h 定义在手腕关键点 p_0 上。
推导: 把手部关键点 p0 选作手腕或掌根原点,先把图像/世界坐标中的点平移到该原点,得到手部局部参考系的起点定义。
读法: 用小指掌指关节指向食指掌指关节的向量定义手掌横向轴 e_x,并除以向量长度将其归一化为单位向量。
推导: 用掌部两点 p5 与 p17 的连线作为横向轴,再除以其二范数做单位化,保证方向特征不受手掌尺度影响。
读法: 先用手腕指向中指掌指关节的方向得到临时纵轴;再用横轴与临时纵轴的叉乘得到手掌法向 e_z;最后再叉乘一次得到与另外两轴正交的纵轴 e_y。
推导: 先把 p9 到 p0 的方向单位化为临时 y 轴,再用叉积构造与 x 轴正交的 z 轴并单位化,最后用 z 叉 x 得到严格正交的 y 轴。
于是手掌位姿可写为 ,其中 。如果对象位姿为 ,更适合学习的是:
读法: 手掌位姿 T_h 由旋转矩阵 R_h 和位置 o_h 组成;旋转矩阵的三列分别是手掌局部坐标系的 x、y、z 三个单位轴。T_o 表示对象在同一参考坐标系中的位姿。
读法: 对象到手掌的相对位姿,等于先用对象位姿的逆变换回到对象坐标系,再应用手掌位姿。结果描述“从对象看,手掌位于哪里、朝向哪里”。
推导: 齐次变换按路径相乘:从对象坐标到手坐标先回到对象变换的逆,再接上手的变换,因此相对变换是 T_o 的逆乘 T_h。
它描述“手相对杯子、抽屉或工具在哪里”,比“手在相机画面的第几个像素”更接近任务因果结构。
💡
当关键点接近共线、手掌侧对相机或发生严重遮挡时,法向 会不稳定。训练数据中必须同时保留可见性和坐标系置信度,并对低置信帧降权或插值。
4. 手指屈曲、抓型与运动估计
4.1 屈曲角与抓型
对一根手指的连续三点 ,关节夹角可写为:
读法: 以关节点 b 为顶点,分别构造从 b 指向 a 和 c 的两条骨骼向量;将两向量的点积除以长度乘积,再取反余弦,得到该关节的夹角 θ。
推导: 两个向量夹角由归一化点积的反余弦给出;a-b 与 c-b 是以 b 为顶点的两条边,点积除以两条边长消除尺度。
组合五指屈曲角、拇指与各指尖距离、掌宽归一化后的指尖间距,可识别 pinch、power grasp、open palm、pointing 等抓型。抓型应被视为概率分布而非硬标签,例如 。
读法: p(g_t∣H_{1:t}) 表示:在已经观察到第 1 帧到第 t 帧的手部历史 H 后,当前抓型 g_t 属于各种候选抓型的条件概率。
4.2 从位置序列估计速度
二维关键点速度是后处理估计:
读法: 第 t 帧、第 j 个关键点的二维速度,用未来第 t+k 帧和过去第 t−k 帧的像素位置之差,除以两帧之间的总时间 2kΔt 进行中心差分估计。
推导: 中心差分用 t+k 与 t-k 两个对称样本的位移除以总时间间隔 2k delta t,截断误差比单边差分更低。
为减弱人物手掌大小和拍摄距离的影响,可用掌宽 归一化:
读法: s_t 是第 t 帧的像素掌宽,等于食指掌指关节与小指掌指关节之间的二维欧氏距离,用作人物尺度和拍摄距离的归一化基准。
读法: 归一化速度等于二维像素位移除以时间间隔和当前掌宽,表示该关键点每单位时间移动了多少个掌宽,而不是多少米。
推导: 在二维速度上再除以尺度 s_t,把像素/帧变化变成相对手部尺度的运动;这样不同距离和不同手大小的样本更可比。
这表示“每秒移动多少个掌宽”,不是米/秒。若有相机内参、深度、多视角或可靠的 3D 手模型,才能进一步估计相机坐标中的三维速度:
读法: 三维速度同样使用中心差分:用未来和过去两个时刻的估计三维位置之差除以总时间。只有三维位置具有可靠公制尺度时,结果才能解释为米每秒。
推导: 将同一中心差分应用于三维重建点 p_hat,得到带真实空间单位的速度估计;前提是深度和坐标系已经校准。
实际管线应先平滑轨迹,再差分;同时输出速度不确定性。相机运动明显时,还需先估计并消除相机自运动。
5. 从手骨架到手-物交互图
机器人真正需要学习的不是一只孤立的手,而是手、对象、环境和事件之间的关系。可把每一帧表示为动态图:
读法: 第 t 帧的交互图 G_t 由三类节点和三类边构成:手节点、对象节点、环境节点,以及手内部骨骼边、手到对象的交互边、对象到环境的关系边。
推导: 把手部节点、物体节点和环境节点分别放入三个顶点集合,再把手-手、手-物和物-环境关系并成边集合,就得到异构交互图。
| 图元素 | 特征示例 | 语义 |
|---|---|---|
| 手节点 | 掌位姿、指尖位置、屈曲角、速度、置信度 | 施动者状态 |
| 对象节点 | 类别、6D pose、尺寸、可动部件、状态 | 被操作对象 |
| 环境节点 | 桌面、容器、支撑面、障碍物 | 约束与上下文 |
| 手-手边 | 骨骼连接、相对角度 | 解剖拓扑 |
| 手-物边 | 距离、相对位姿、接近速度、接触概率 | 交互关系 |
| 对象-环境边 | 支撑、包含、铰接、碰撞关系 | 对象状态变化的物理约束 |
一个可解释的接触概率模型可写成:
读法: 第 t 帧中,第 i 个手部点与对象 o 发生接触的概率,由 sigmoid 函数把一组证据映射到 0 到 1:距离越近、接近趋势越明显、对象状态变化越一致,接触概率通常越高;φ_t 表示其他上下文特征。
推导: 用 sigmoid 把距离、接近速度、物体状态变化和上下文特征的线性组合压到 0 到 1,得到接触事件发生的概率模型。
其中 是指尖到对象表面的距离, 是接近速度, 是对象状态变化, 是遮挡、视角和检测置信度等上下文。这个量仍然是视觉证据下的接触概率,不等于真实接触力。
6. 2D 骨架、3D 骨架、MANO 与多视角如何选择
| 表示 | 优点 | 主要缺点 | 推荐用途 |
|---|---|---|---|
| 2D 21 点 | 便宜、稳定、可规模化 | 深度与遮挡歧义大 | 粗筛、动作阶段、二维轨迹 |
| 单目 3D 关键点 | 提供相对三维结构 | 尺度、旋转和遮挡误差 | 预训练表征与相对运动 |
| MANO 参数 | 连续手形和姿态,便于渲染 | 拟合成本高,模型偏差明显 | 高价值片段、合成增强、几何一致性 |
| 多视角 3D | 精度和可观测性更高 | 采集成本与标定成本高 | 金标集、评测集、接触研究 |
| 第一视角 + 手-物 | 接近机器人视角,任务信息密集 | 遮挡强、手常出画 | 操作策略预训练 |
规模化方案不应只选一种表示。建议采用“海量 2D/弱 3D + 中量 MANO/对象轨迹 + 小量多视角与力触觉金标”的分层数据结构。
7. 公开论文与数据集
- MediaPipe Hands:实时单目手部关键点检测,21 点拓扑的常用工程基线。
- HaMeR:从图像恢复 3D 手部网格,适合高价值片段的 MANO 或网格估计。
- WiLoR:面向野外图像的 3D 手部重建,强调大规模和复杂场景。
- ARCTIC:双手与可动对象的三维交互数据,适合研究接触和对象状态。
- HOT3D:第一视角手-物三维数据,包含手和对象的时空关系。
- EgoDex:面向灵巧操作的第一视角人类数据与学习框架。
- EgoMimic:利用第一视角人类视频与机器人数据学习操作行为。
- DexImit:关注从人类灵巧操作到机器人模仿的表示与迁移。
阅读这些工作时要核查: 关键点是人工真值、动作捕捉真值还是模型伪标签;对象位姿是否标定;接触是几何阈值还是传感器测量;速度是否有公制尺度。
8. 对 Behavior Prompt / Tokenizer 的建议
不建议把 21 个点逐坐标量化后直接当成行为 token。更合理的是分层 tokenizer:
- 阶段 token: reach、pre-grasp、contact、manipulate、release、retract。
- 关系 token: 手相对对象的方向、距离区间、朝向和接近或远离趋势。
- 抓型 token: pinch、power grasp、support、push、pull 等概率编码。
- 局部几何 token: 掌姿态、指尖布局和屈曲角的连续残差。
- 事件 token: 首次接触、对象开始运动、铰接状态改变、释放。
- 不确定性 token: 遮挡、低置信度、尺度未知、相机运动强。
训练目标可写为:
读法: 总训练损失 L 是五个子目标的加权和:几何重建、未来预测、人类与机器人表示对齐、交互事件识别和机器人动作监督;每个 λ 都控制对应损失在总目标中的相对权重。
推导: 多任务训练把重建、下一状态预测、跨模态对齐、事件检测和机器人监督的损失按权重相加;每个 lambda 控制对应证据在总梯度中的相对影响。
- :重建局部手-物几何,防止 token 丢失关键细节。
- :预测未来关系、抓型和对象状态,学习动力学趋势。
- :对齐人类视频与机器人轨迹中的共享语义。
- :监督接触、移动、释放等事件边界。
- :只在机器人数据上监督可执行动作或 action chunk。
这样,人类数据主要塑造共享的条件行为分布与事件结构;机器人数据负责把共享语义落到具体 embodiment 的控制空间。
9. 机器人迁移的边界
| 可以迁移 | 需要适配 | 不能直接迁移 |
|---|---|---|
| 接近方向、对象中心轨迹、抓取阶段、对象状态变化 | 手掌尺度、自由度、抓型、工作空间、速度范围 | 人手关键点到机器人 qpos 的逐点映射 |
| 双手协同关系、工具-对象关系、接触时序 | 相机视角、控制频率、延迟、顺应性 | 由视觉骨架推断真实力矩和摩擦系数 |
| 成功前后的因果事件链 | 对象材质和动力学、末端执行器形态 | 把单目估计米/秒当成控制速度真值 |
10. 最小可行实验
10.1 数据
- 选择 3 类任务:抓杯、开抽屉、拿工具;每类至少包含成功、失败和恢复片段。
- 人类视频输出 21 点骨架、对象 mask 或 pose、相机运动、接触概率、任务 phase 与置信度。
- 机器人数据额外包含末端位姿、夹爪状态、q/dq、力矩或触觉和成功标签。
10.2 对照组
- RGB-only 视频预训练。
- RGB + 手骨架。
- RGB + 手骨架 + 对象轨迹。
- RGB + 完整手-物交互图 + 事件 token。
10.3 决定性指标
- 人类视频上的接触事件 F1、对象状态预测准确率和未来相对轨迹误差。
- 机器人少样本微调后的任务成功率、所需机器人轨迹数和未见对象泛化。
- 遮挡、相机运动、左右手、不同手型下的鲁棒性。
- 失败分类:抓空、接触后滑移、姿态不匹配、对象未动、控制延迟与恢复失败。
✅
Go/No-Go 判据: 只有当“手-物交互表示”相对 RGB-only 和骨架-only,在相同机器人数据预算下稳定提高真实机器人成功率,并且收益在未见对象或未见操作者上保留,才说明它学到了可迁移行为结构,而不是更强的视觉拟合。
11. 最终判断
手掌骨骼线值得规模化生成,但它的正确角色是中间观测层,不是最终动作层。最有价值的训练单位不是“第 8 号指尖移动了多少像素”,而是“哪只手以什么抓型、从哪个方向、在多大不确定性下接近哪个对象,并引发了什么可观测状态变化”。
因此,数据管线应从 hand-centric 进一步升级为 object-centric hand-object interaction,再用少量高质量机器人数据完成 embodiment grounding。