

飞书原文 · 源修订 21
💡
机制课: 学习策略输出参考动作,反馈控制器把参考变成稳定运动。本课从线性状态空间、闭环极点、PD、离散采样、饱和和 Lyapunov 直觉出发,建立策略与控制器的接口。
学习目标
完成本课后,应能写出状态空间模型;解释开环和闭环;推导 PD 二阶误差方程;用特征值判断线性稳定性;分析离散采样、延迟、饱和和动作平滑;区分策略错误与控制跟踪错误。
1. 状态空间
线性系统:
读法: 状态变化率等于系统自身演化 A x 与控制输入作用 B u 之和。
推导: 把非线性动力学在某个工作点做一阶 Taylor 展开,常数项在平衡点抵消,状态与输入的一阶偏导分别形成 A 和 B。该模型只在工作点附近近似有效。
读法: 可测输出 y 是内部状态 x 经过矩阵 C 的线性投影。
推导: 传感器通常只观察状态的一部分或线性组合。本课为避免控制输入直接进入输出造成代数环,采用 D 等于零的情形;若存在 y=Cx+Du,闭环代入必须单独处理 D。
其中,x 表示内部状态,u 表示控制输入,y 表示可测输出。机器人非线性动力学可以在选定工作点附近线性化,但线性模型的有效范围必须通过扰动和轨迹测试验证。
2. 开环与闭环
开环控制只根据预先计划给输入;闭环使用误差:
读法: 控制输入等于增益 K 乘参考输出与实际输出之间的误差。
推导: 负反馈让输出低于参考时产生纠正输入,输出高于参考时反向纠正。K 可以是标量或矩阵,符号约定改变时必须同步改变闭环矩阵。
代入得到:
读法: 闭环状态由修改后的系统矩阵 A 减 BKC 演化,并受到参考输入 BKr 驱动。
推导: 在 y=Cx 且 u=K(r-y) 下,把 u 代入 A x+B u,展开并合并 x 项即可得到。零参考时,A-BKC 的特征值实部决定连续线性闭环的局部稳定性。
闭环矩阵特征值实部为负时,连续线性系统局部渐近稳定。
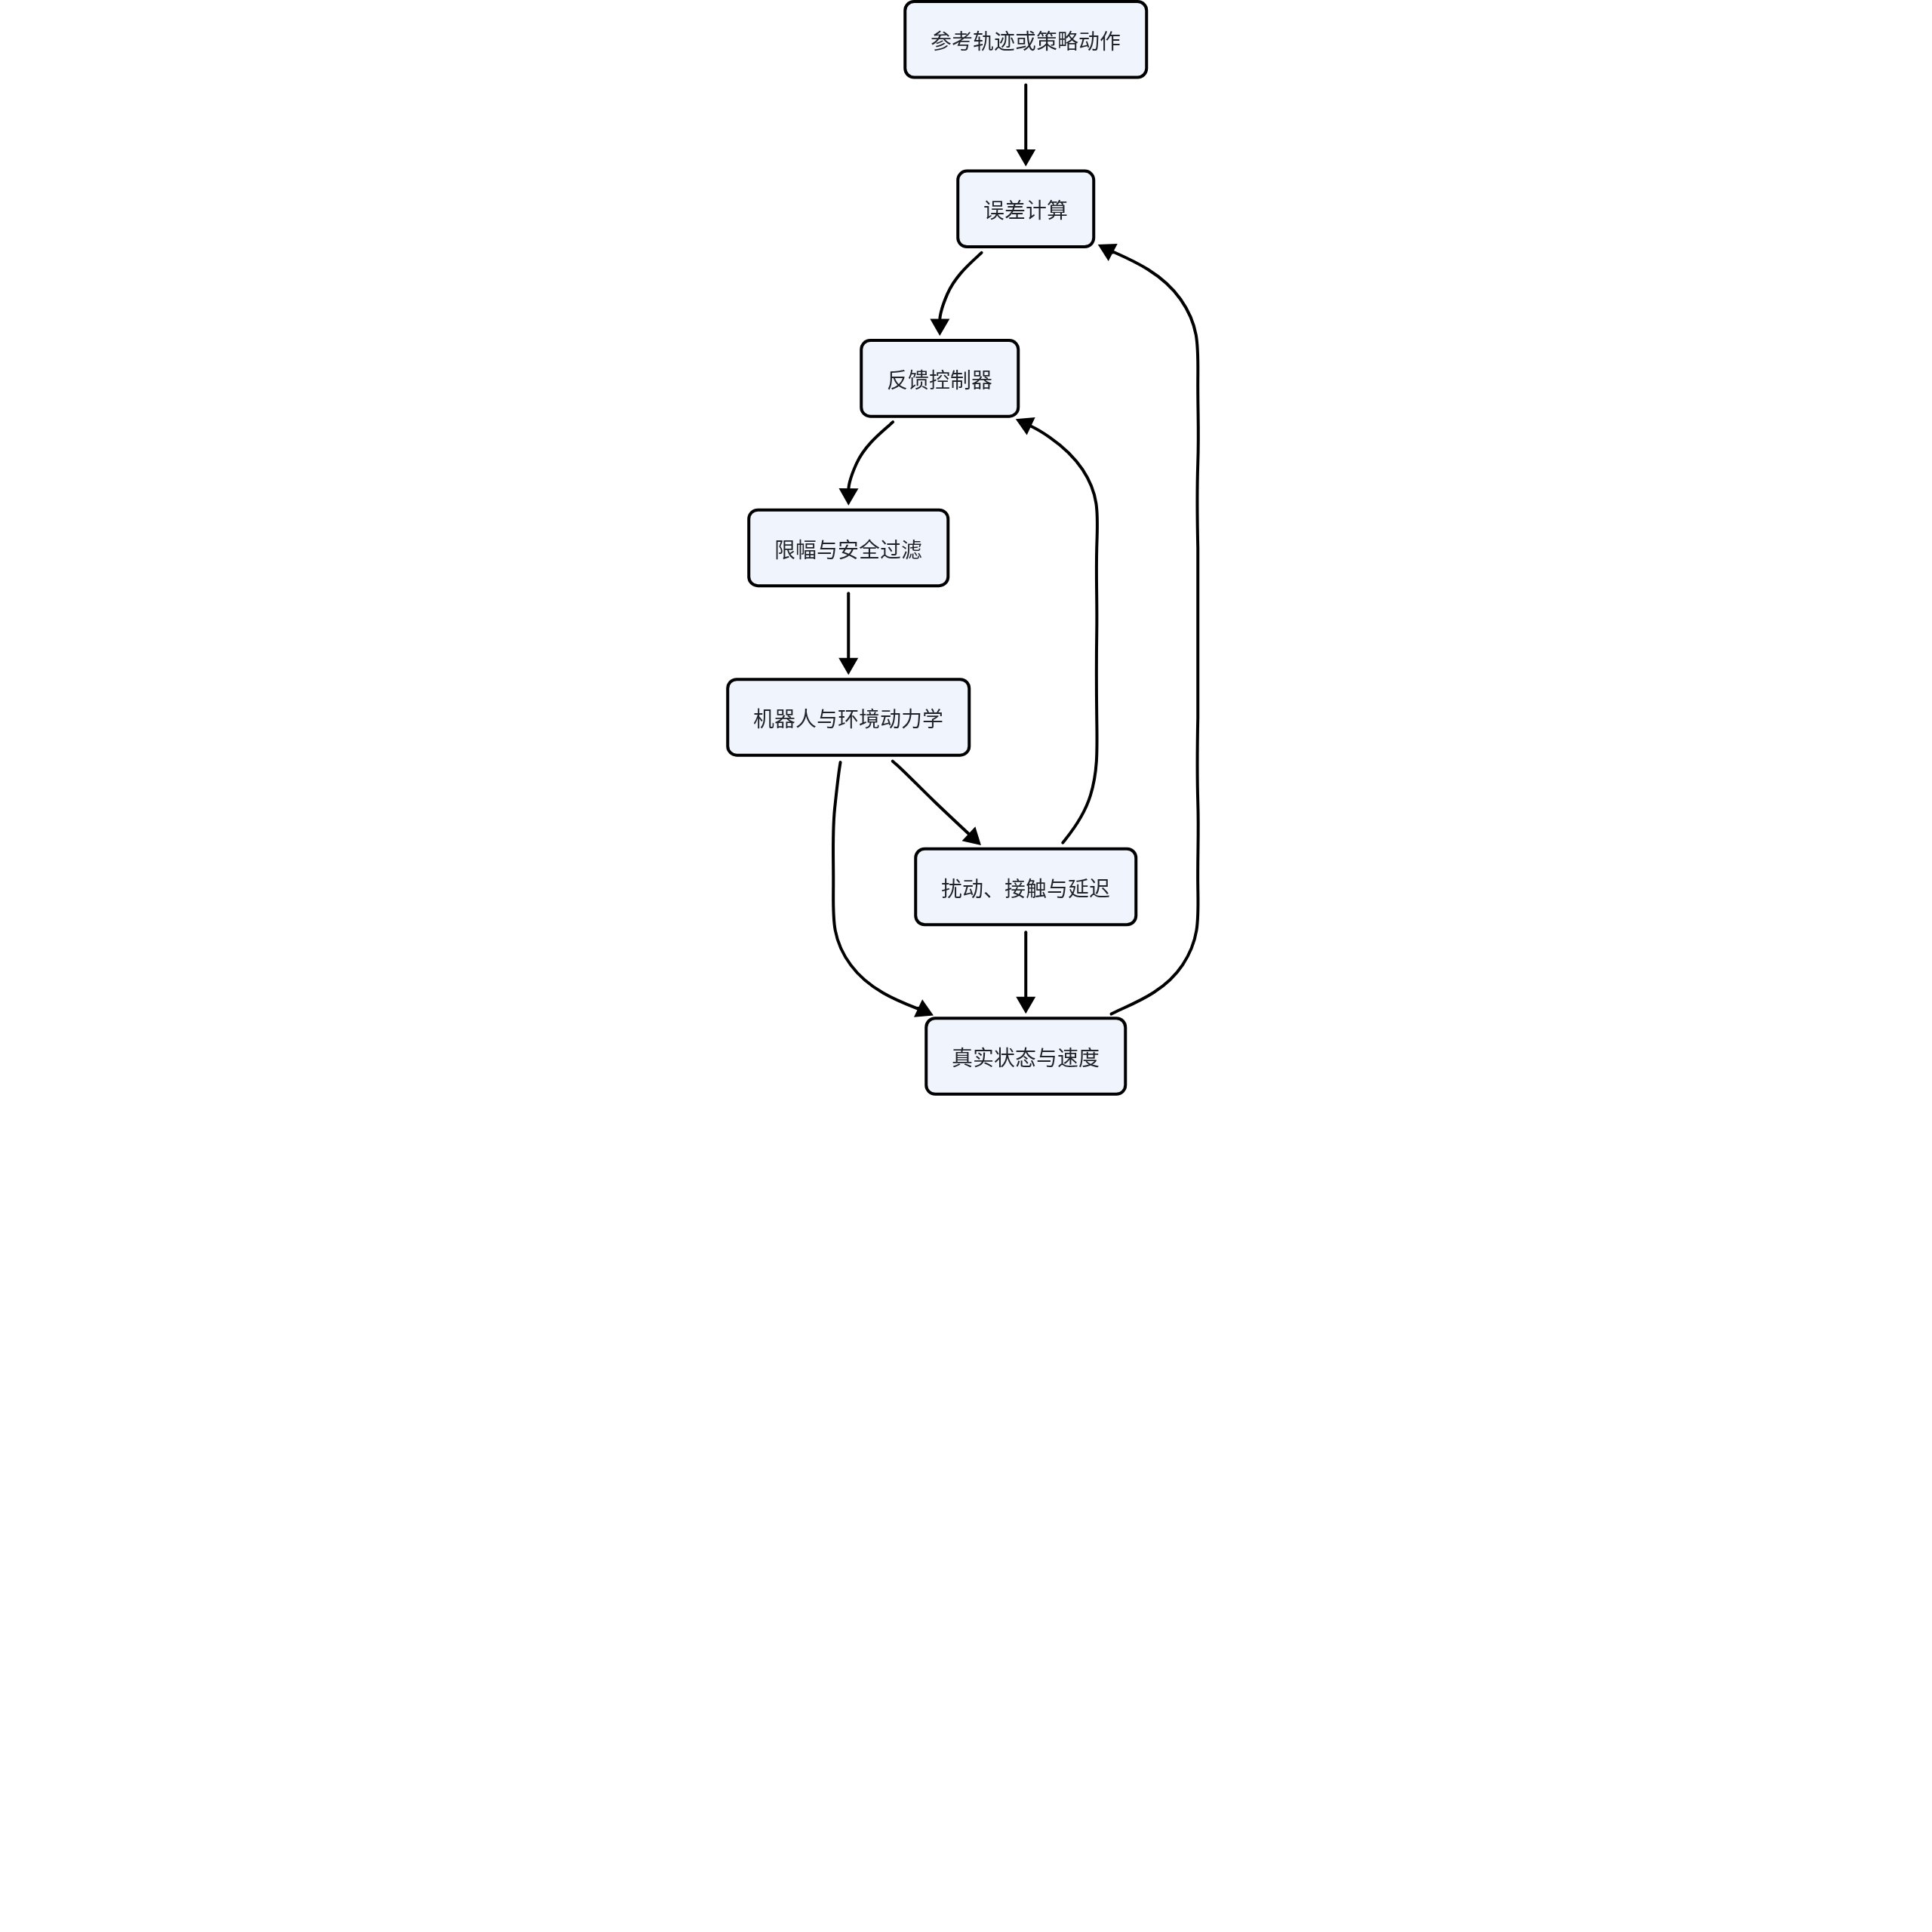
3. 一维 PD 推导
质量系统:
读法: 一维质量 m 的加速度乘质量等于控制力 u。
推导: 这是牛顿第二定律在忽略摩擦、重力和外力后的最小模型。它用于展示反馈结构,不代表完整机器人关节动力学。
控制律:
读法: PD 控制输入由位置误差和速度误差分别乘比例、微分增益后相加。
推导: 比例项提供恢复力,微分项提供阻尼。K_p、K_d 为正时,固定目标附近形成弹簧阻尼行为;实际执行器饱和和采样延迟会限制增益。
目标固定,误差 :
读法: 以 e 等于当前位置减目标位置定义误差时,PD 闭环误差满足标准齐次二阶方程。
推导: 目标固定时 e_dot=q_dot、e_ddot=q_ddot。把 q_d-q=-e 和负 q_dot 代入控制律,再代入 m q_ddot=u,移项即可得到。
自然频率和阻尼比:
读法: 闭环自然频率是 K_p 除以质量的平方根,阻尼比是 K_d 除以二倍根号 mK_p。
推导: 把误差方程除以 m,与标准二阶式 e_ddot+2 zeta omega_n e_dot+omega_n 平方 e=0 对比系数,即得到两式。
比例增益主要决定等效刚度与响应速度,微分增益主要提供耗散并抑制振荡。增益过高会放大测量噪声、时延、执行器柔性和未建模高频模态。
4. 离散时间
控制器实际按周期 更新:
读法: 离散系统的下一状态由当前状态和当前控制输入通过离散矩阵 A_d、B_d 计算。
推导: 在采样周期 Delta t 内保持输入不变,对连续线性系统积分可得 A_d=e^{A Delta t},B_d 为矩阵指数积分。离散稳定要求闭环特征值模长小于一。
离散稳定要求闭环特征值位于单位圆内。相同 PD 增益在 1 kHz 和 20 Hz 下行为不同。
5. 延迟
延迟控制:
读法: 控制器根据 delta 秒以前的参考与输出误差计算当前输入。
推导: 观测、计算和通信使控制器只能看到过去信息。纯延迟在频域引入随频率增加的相位滞后,从而降低稳定裕度;实际延迟应按时间戳分布而非单一平均值建模。
延迟增加相位滞后,降低稳定裕度。VLA 推理时间、网络通信和 Action Chunk 都进入总延迟。
6. 饱和与 anti-windup
执行器存在:
读法: 控制输入必须位于执行器允许的最小值和最大值之间。
推导: 电流、力矩、速度和行程都有物理上限,命令超限会被裁剪。裁剪是非线性,会改变线性闭环;若还有积分项,持续误差会积累造成 windup,因此需要 anti-windup。
饱和使线性分析失效。积分控制器在饱和时会 windup,需要 anti-windup。学习策略也必须在动作归一化和解码后满足物理范围。
7. Lyapunov 直觉
若存在能量函数:
读法: Lyapunov 函数在平衡点为零,其他状态为正,并沿所有非平衡轨迹严格下降。
推导: V 可理解为广义能量。若状态离开平衡点就具有正能量,而系统运动又持续消耗能量,轨迹不能长期停在非零能量处,因此平衡点渐近稳定。半负定情形还需 LaSalle 等额外条件。
系统状态会向平衡点收敛。对 PD 质量系统可选:
读法: 候选 Lyapunov 函数由误差速度的动能项和位置误差的虚拟弹簧势能项组成。
推导: 质量系统的动能是二分之一 m e_dot 平方,比例控制相当于刚度 K_p 的弹簧,势能是二分之一 K_p e 平方。m、K_p 为正时,V 对误差状态正定。
求导:
读法: Lyapunov 函数变化率等于负的微分增益乘误差速度平方,因此不会增加。
推导: 对 V 求导得到 m e_dot e_ddot+K_p e e_dot,再用 PD 误差方程替换 m e_ddot,弹簧项抵消后只剩负阻尼耗散。V_dot 为零时 e_dot=0;结合动力学可用 LaSalle 推出最终 e=0。
这解释微分项耗散能量。
8. 轨迹跟踪
策略输出 Action Chunk 。控制器跟踪每个参考点。需要检查:
- 参考轨迹是否连续可达。
- 速度和加速度是否超限。
- chunk 边界是否跳变。
- 跟踪误差是否反馈给策略。
9. 策略-控制器接口
| 策略输出 | 控制器 | 风险 |
|---|---|---|
| 关节位置 | 位置 PD | 刚性接触 |
| 关节速度 | 速度伺服 | 积分漂移 |
| 末端位姿 | IK + 位置控制 | 奇异和不可达 |
| 力矩 | 电流环 | 安全与高频要求 |
| 阻抗参数 | 力/阻抗控制 | 稳定性和传感 |
10. 诊断实验
- 记录目标动作和真实轨迹。
- 单独测控制器跟踪误差。
- 使用理想控制器仿真策略。
- 固定策略扫描增益和频率。
- 固定控制器比较不同策略。
- 注入延迟、噪声和饱和。
11. 本课练习
- 推导 PD 的阻尼比。
- 计算离散闭环特征值。
- 用 Lyapunov 函数解释 PD 稳定。
- 设计 chunk 边界平滑器。
- 解释高策略成功率为什么可能掩盖控制器不稳定。
- 区分模型推理延迟和执行器延迟。
12. 最小实验:稳定性、采样与策略接口
从一维质量和倒立摆或两关节机械臂开始,固定参考轨迹,分别实现连续近似、离散 PD、带延迟控制、饱和和 anti-windup。随后让同一学习策略输出参考轨迹,保持控制器可替换。
- 扫描 K_p、K_d、采样周期和延迟,画闭环极点、超调和收敛时间。
- 比较理论离散模型与真实时间戳下的轨迹。
- 注入动作饱和、传感器噪声和 chunk 边界跳变。
- 固定策略换控制器,固定控制器换策略,分离两类错误。
- 增加安全过滤器,比较未经修改的策略动作与实际执行动作。
最低报告项: 闭环特征值、Lyapunov 候选变化、跟踪误差、超调、收敛时间、饱和率、动作修改率、端到端延迟、任务成功率和安全违规。
13. 主要失败模式
| 失败 | 表现 | 诊断与修正 |
|---|---|---|
| 连续稳定、离散不稳 | 理论增益在低频控制器中振荡 | 离散极点、真实采样抖动和零阶保持模型 |
| 延迟裕度不足 | 轻微推理或网络延迟导致超调放大 | 延迟扫描、相位裕度和预测补偿 |
| 高增益放大噪声 | 跟踪更快但电机抖动、能耗和磨损上升 | 速度估计噪声、滤波和控制频谱 |
| 饱和与 windup | 长时间超限后恢复迟缓或严重过冲 | 命令/实际动作、积分状态和 anti-windup |
| 参考轨迹不可行 | 控制器稳定但永远追不上策略输出 | 速度、加速度、jerk 和可达性约束 |
| Chunk 边界跳变 | 相邻动作块在连接处产生速度或力尖峰 | 边界连续性、插值和在线中断重规划 |
| Lyapunov 条件误用 | 只证明 V_dot 小于等于零就声称严格收敛 | 检查不变集、LaSalle 条件和模型适用域 |
| 安全过滤掩盖策略缺陷 | 任务成功但大部分动作被过滤器修改 | 动作修改率、未过滤反事实和策略再训练 |
14. 论文事实、作者解释与课程判断
| 路线 | 论文事实 | 作者解释 | 课程判断 |
|---|---|---|---|
| LQR / 线性控制 | 在线性动力学和二次代价下求得最优状态反馈,并可分析闭环极点 | 模型结构可以提供可解释的稳定与性能权衡 | 它是局部地基,不覆盖强接触、多峰观测和大范围非线性 |
| Control Barrier Function | 通过在线优化约束系统保持在安全集合内,可与名义控制器组合 | 安全约束可以作为控制层过滤器独立于策略实现 | 安全证明依赖动力学模型、相对阶和可行性;应报告过滤修改率与失效条件 |
| Residual RL | 学习策略在已有控制器上叠加残差,以修正模型误差或复杂动力学 | 稳定先验与学习能力可以互补 | 残差边界、探索安全和基线控制器质量必须纳入评测 |
| Action Chunk 策略 | 一次预测多步动作可降低推理频率并利用时间相关性 | 动作块有助于长时连续控制 | chunk 越长开环风险越大,必须测延迟、边界连续性和扰动中断能力 |